在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B,实现多语言推理
Fine-tuning GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod
AWS 展示了在 Amazon SageMaker HyperPod 上使用 SFT 和 GRPO 微调 GPT-OSS-20B,以改善法语、德语、西班牙语和意大利语推理的实践。
文章提供了在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B 的复现实操,并用对照实验说明 SFT 与 GRPO 分别适合弥补行为缺失和优化已有能力。
GPT-OSS-20B 是一个用英语思考的开放权重推理模型。要求它用法语、德语、西班牙语或意大利语进行推理,它会确认指令,然后仍然用英语生成思维链。在一项包含 50 个样例的多语言推理测试中,基础模型仅有 22% 的时间能用正确的目标语言进行推理。这 22% 几乎完全来自英语样例(英语 100%,法语 0%,德语 10%,西班牙语 0%,意大利语 0%)。
对于面向非英语用户部署推理模型的团队来说,这种差距很重要。用法语提问的用户希望模型用法语推理并作答,而不是在思考过程中切换成英语。弥合这一差距需要进行微调。这也引出了每个团队在开始定制开放权重模型时都会面临的问题:监督微调(SFT)、基于组相对策略优化(GRPO)的强化学习,还是两者兼用?
在本文中,我们将介绍如何在 Amazon SageMaker HyperPod 上对 GPT-OSS-20B 进行多语言推理微调。我们将展示何时仅用 SFT 就足够,以及 GRPO 何时能在此基础上带来可衡量的价值。为了更全面地了解 GRPO 在何时能发挥作用,我们还围绕两项能力差距不同的任务,对 Qwen2.5-7B 进行了一项受控实验。简而言之:SFT 完成大部分工作,GRPO 会在有提升空间时进一步优化,而能否根据能力差距选择合适的技术,决定了最终结果。
解决方案概述
本节介绍多语言推理任务和数据集、SFT 与 GRPO 如何相辅相成,以及我们在 Amazon SageMaker HyperPod 上使用的训练技术栈。
任务和数据集
该数据集是 HuggingFaceH4/Multilingual-Thinking——一个思维链推理数据集,除英语外,还翻译成法语、西班牙语、德语和意大利语,约有 949 个训练样例和 50 个验证样例。模型会收到一条 reasoning language: 系统提示指令,必须使用指定的目标语言进行推理并作答,克服其强烈的英语倾向。评估包含 50 个测试用例:涵盖 5 种语言(EN/FR/DE/ES/IT)的 10 道数学/逻辑题。
两个指标至关重要:
- 推理语言正确 – 思维链是否使用了指定语言?
- 答案语言正确 – 最终答案是否使用了指定语言?
SFT 和 GRPO 如何配合
理解这两种技术最清楚的方式是:SFT 教会模型一种它尚不具备的行为。GRPO 则优化模型已经偶尔能够生成的行为。GRPO 的工作方式是为每个提示采样一组回复,并推动策略偏向表现高于平均水平的回复。如果目标行为在基础分布中的概率为零,那么 GRPO 几乎没有什么可以强化。这一个概念就能解释本文中几乎所有结果。
训练技术栈
我们在 Amazon SageMaker HyperPod 上运行训练,并使用 Amazon Elastic Kubernetes Service (Amazon EKS) 进行编排。对于 GPT-OSS-20B 的初始 SFT 和 GRPO 训练,我们使用了 PyTorch TRL 库。对于 Qwen 对照实验,我们改用 veRL 作为训练器,并使用 Ray 和 KubeRay 进行分布式编排,使用 vLLM 快速生成 rollout。检查点和数据集存储在 Amazon FSx for Lustre 上,节点间网络使用 Elastic Fabric Adapter (EFA)。所有微调均采用低秩适应(LoRA),这种方法参数效率高,非常适合 SFT 和 GRPO。
下图展示了端到端的训练数据流。用户提交的任务会到达 Amazon SageMaker HyperPod 集群的 Amazon EKS 控制平面。Amazon EKS 会调度一个 Ray head pod 和多个 worker pod,运行 veRL trainer 和 vLLM rollout workers。两组 pod 都会挂载 Amazon FSx for Lustre,以访问基础模型、训练数据和检查点。节点间集合通信使用 EFA。Rollout 数据从 vLLM 流式传回 veRL trainer,trainer 再将检查点写回 Amazon FSx for Lustre。
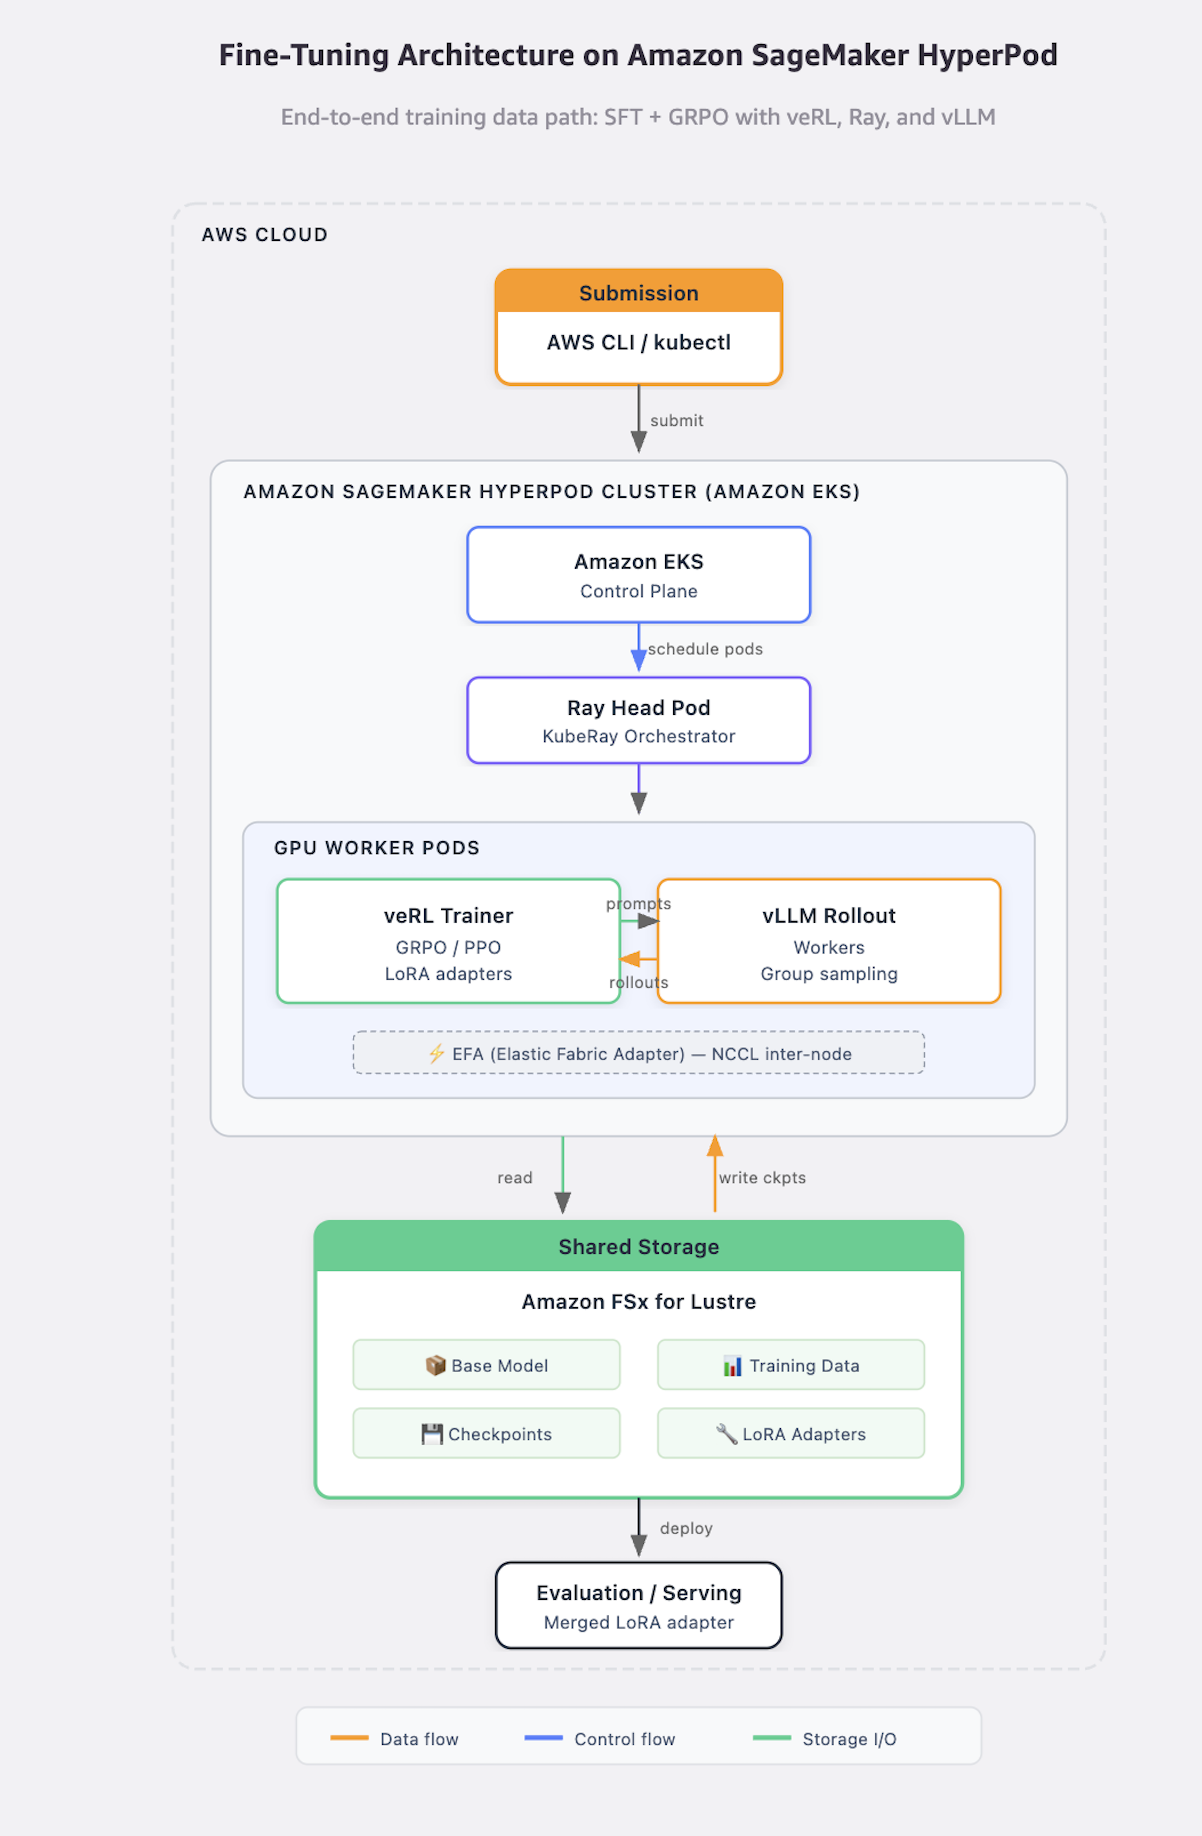
图 1:在 Amazon SageMaker HyperPod 上,使用 veRL、Ray、KubeRay、vLLM 和 Amazon FSx for Lustre 对 Qwen 进行控制实验时,SFT 和 GRPO 微调的端到端训练数据流
下面将更详细地介绍各个环节。提交者从 Amazon SageMaker Studio 或 AWS Command Line Interface (AWS CLI) 启动任务。Amazon SageMaker HyperPod 上的 Amazon EKS 控制平面会将 pod 部署到 GPU 节点,并启动一个 Ray head 及其 worker pod,分别运行 veRL trainer 和 vLLM rollout workers。Amazon FSx for Lustre 为基础模型、训练数据和检查点提供共享的高吞吐量存储。训练完成后,trainer 会将 LoRA 适配器写回 Amazon FSx for Lustre,以供后续评估或服务使用。
先决条件
要跟着本文操作,你需要:
- 一个使用 Amazon EKS 进行编排的 Amazon SageMaker HyperPod 集群。GPT-OSS SFT 使用了 4× ml.g6e.12xlarge(16× L40S 48GB)。Qwen 控制实验使用了 2× g6e.48xlarge(16× L40S)。
- 一个挂载到集群的 Amazon FSx for Lustre 文件系统,其中包含名为
fsx-claim、位于/fsx的PersistentVolumeClaim。 - 支持 EFA 的实例,以及可正常运行的 NVIDIA Collective Communications Library (NCCL) 和
aws-ofi-nccl堆栈,用于多节点 SFT。 - 一个容器注册表,例如 Amazon Elastic Container Registry (Amazon ECR),用于存放基于参考存储库构建的训练镜像。
- 用于
openai/gpt-oss-20b和HuggingFaceH4/Multilingual-Thinking数据集的 HuggingFace 访问令牌。 - 工作站上已安装 AWS Command Line Interface (AWS CLI)、
kubectl、docker和envsubst。
设置训练环境
下文引用的所有命令、清单和脚本都位于 GitHub 存储库 awsome-distributed-ai 的 3.test_cases/pytorch/trl/gpt-oss-lora-grpo/ 目录下。克隆存储库并切换到测试用例目录:
git clone https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
复制环境模板,然后编辑 env_vars,设置 ECR 注册表、镜像名称、标签和 HuggingFace 令牌:
cp env_vars.example env_vars
source env_vars
构建训练镜像并将其推送到你的注册表。该镜像包含 PyTorch、TRL、HuggingFace Transformers、PEFT,以及训练和推理脚本:
cd artifacts && ./build_push.sh && cd ..将 kubectl 指向你的集群并应用 FSx storage manager pod。storage manager 可让你进入共享文件系统的 shell,以进行检查点转换和评估日志检查:
aws eks update-kubeconfig --name <YOUR_CLUSTER_NAME> --region us-east-2
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/fsx-storage-manager.yaml | kubectl apply -f -
使用 SFT 和 LoRA 微调 GPT-OSS-20B
我们先测量基础模型的表现,然后配置 SFT 任务并查看结果。
基础模型的差距
基础 GPT-OSS-20B 在包含 50 个案例的评估中得分为 推理语言正确率 22 percent(11/50)。按语言划分:英语 100 percent、法语 0 percent、德语 10 percent、西班牙语 0 percent、意大利语 0 percent。无论指令如何,模型默认都使用英语进行推理。
SFT 配置
SFT 设置使用 LoRA r=8、α=16,在 4× ml.g6e.12xlarge(16× L40S 48GB)上训练 1,000 步,采用 Fully Sharded Data Parallel (FSDP) 全分片、bf16 精度和梯度检查点。该作业作为由 Kueue 管理的弹性 HyperPodPyTorchJob 运行,并使用 hyperpodrun 启动。
应用 SFT 清单:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < hyperpod-eks/train-lora-hyperpod-elastic-g6e.yaml | kubectl apply -f -
查看训练进度:
kubectl get pods -l app=gpt-oss-lora-elastic
kubectl logs -f -l app=gpt-oss-lora-elastic
每一步都会输出损失和梯度范数。正常运行的输出如下:
{'loss': 1.035, 'grad_norm': 0.163, 'learning_rate': 0.0002, 'mean_token_accuracy': 0.716, 'epoch': 3.25}
{'loss': 1.003, 'grad_norm': 0.171, 'lr': 0.0002, 'acc': 0.722, 'epoch': 3.32}
{'loss': 0.976, 'grad_norm': 0.159, 'lr': 0.0002, 'acc': 0.726, 'epoch': 3.57}
训练完成后,将 FSDP 检查点转换为参数高效微调(PEFT)格式,这是 TRL 的 GRPO 训练器和推理脚本所需的格式:
kubectl exec -it fsx-storage-manager -- python /app/convert_fsdp_checkpoint.py \
  --checkpoint /fsx/checkpoints/checkpoint-1000 \
  --output    /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft
SFT 结果与分阶段学习曲线
SFT 后,模型在全部五种语言中100 percent of the time(50/50)都能使用正确的语言进行推理。SFT 分两个阶段学会了这一点:
- 大约在第 200 步,模型学会了用目标语言推理(推理语言指标达到 100 percent)。
- 大约在第 1000 步,模型还学会了用目标语言给出答案。
SFT 最终评估(第 1000 步):
- 推理语言正确率:100 percent(50/50)。
- 答案语言正确率:62 percent(31/50)。
- 两者均正确:62 percent(31/50)。
- 各语言答案准确率:FR 60 percent,DE 60 percent,ES 30 percent,IT 60 percent,EN 100 percent。
要点:在这里,SFT 并非可有可无。基础模型完全无法遵循指定推理语言的指令,而 SFT 将推理语言正确率从 22 percent 提升到 100 percent。剩下的差距在于答案语言,正确率为 62 percent。这是更难的一半,因为最终答案很短,而且英语先验在这方面最强。
用 GRPO 改进答案语言
答案语言显然是 GRPO 的优化目标。SFT 已经让模型 100 percent 的时间都能正确推理,而且模型有时会用正确语言作答,因此有可供强化的信号。
在 SFT 检查点基础上运行 GRPO
我们使用 TRL 的 GRPOTrainer,从 SFT 检查点开始运行 GRPO。设置如下:加载 SFT LoRA,调用 merge_and_unload,并添加一个新的 LoRA(r=8,α=16,可训练参数约占 0.068 percent,即 20B 参数中的 13.6M)。训练时每个提示生成 K=8 个结果,device_map=auto,学习率为 1e-6,共训练 10 个 epoch。奖励函数对答案语言(±5.0)、推理语言(±1.5)和简洁度(+0.5 或 −1.0)进行评分,合计范围为 −7.5 至 +7.0。
从转换后的 SFT 检查点启动 GRPO:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/train-grpo-singlenode.yaml | kubectl apply -f -
kubectl logs -f grpo-single
GRPO 将检查点写入 /fsx/checkpoints/grpo-singlenode/。根据留出评估选择最佳检查点(本次运行中,答案语言指标很早就达到峰值),并将其转换为 PEFT 格式,以便推理和评估。
结果(从 SFT 检查点开始):
- 推理语言正确率:100 percent(保持不变:GRPO 没有破坏 SFT 学到的能力)。
- 答案语言正确率:62 到 70 percent(提升 8 个百分点,35/50)。
- 两者均正确:70 percent。
- 各语言答案准确率:FR 70 percent,DE 80 percent,ES 60 percent,IT 40 percent,EN 100 percent。
GRPO 让答案语言指标真正提升了 8 个百分点,同时将推理语言正确率保持在 100 percent。提升出现在有提升空间的地方。答案语言是 SFT 尚未完全收敛、但有时能正确实现的行为,而 GRPO 对其进行了强化。
并列比较基础模型、SFT 和 GRPO 的推理结果
要了解定性差异,可以部署三个推理 pod,它们共用同一个基础模型,但加载不同的适配器:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-base.yaml    | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-trained.yaml | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-grpo.yaml    | kubectl apply -f -
将同一个法语推理提示分别输入每个变体:
kubectl exec -it inference-base    -- python /app/inference_g6e.py \
  --reasoning_language French

kubectl exec -it inference-trained -- python /app/inference_g6e.py \
  --checkpoint /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft \
  --reasoning_language French

kubectl exec -it inference-grpo    -- python /app/inference_grpo_new.py \
  --use_grpo \
  --grpo_checkpoint /fsx/checkpoints/converted-peft/checkpoint-1470-peft \
  --reasoning_language French
基础模型无视指令,使用英语推理。SFT pod 使用法语推理,但经常用英语回答。GRPO pod 则使用法语推理和回答。要复现生成前述数据的完整 50 个案例评估,请运行评估清单,并从 FSx 存储管理器读取结果文件:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/eval-grpo.yaml | kubectl apply -f -
kubectl logs -f eval-grpo
kubectl exec fsx-storage-manager -- \
  cat /fsx/experiments/grpo_eval_checkpoint1470_*.txt
为了更全面地了解 GRPO 在何时能带来价值,我们在 Qwen2.5-7B 上针对两个能力差距不同的任务开展了受控实验。
用 Qwen2.5-7B 控制组测试该模式
为了在不同模型和不同任务上检验“让技术匹配能力差距”这一论点,我们在 Qwen2.5-7B-Instruct 上进行了对照实验。第一个任务是相同的多语言推理任务(存在提升空间)。第二个任务是 GSM8K,模型在该任务上的准确率已达峰值。这是一项内部实验,公开代码仓库尚未发布。
基础设施:2× g6e.48xlarge(16× L40S)、EFA 100Gbps、FSx Lustre、Ray 2.44 + KubeRay 1.4.2、veRL v0.6.1、vLLM 0.8.4。
实验组:A = 基础模型,B = 仅 SFT,C = SFT+GRPO。
多语言推理(50 个案例)
| 指标 | A 基础模型 | B SFT | C SFT+GRPO | Δ GRPO |
| 结构化格式 | 0% | 92% | 98% | +6 |
| 推理语言 | 0% | 96% | 98% | +2 |
| 回答语言 | 0% | 38% | 44% | +6 |
| 两者均正确 | 0% | 38% | 44% | +6 |
GSM8K:没有提升空间的任务
在 GSM8K 上,基础版 Qwen2.5-7B 的得分已达 90.5 percent(181/200)。第 30 步的 GRPO 得分也为 90.5 percent。当大多数采样组都全部答对时,组相对优势会降至零,因此没有学习信号。这是该论点的另一面:GRPO 需要提升空间(pass@k >> pass@1),才有可优化的对象。没有提升空间,就不会带来增益。
最佳实践
- 从 SFT 开始。GRPO 无法教会模型基础概率为零的行为;它只能强化模型偶尔已经会生成的回答。SFT 将推理语言的表现从 22 percent 提升到 100 percent,而本研究中 GRPO 的所有增益都建立在该 SFT 检查点之上。
- SFT 和 GRPO 都使用 LoRA。LoRA r=8/α=16 参数效率高(可训练参数占 0.068 percent),并且在 Qwen 对照实验中,经过 GRPO 训练后仍保持数值稳定(梯度范数为 0.23,每个 GPU 约 11.7 GB)。如果希望 SFT 和 GRPO 使用相同形状的适配器,这是一个很好的默认选择。
- 让技术匹配能力差距。缺失的行为用 SFT。对于已存在但仅偶尔正确的行为,用 GRPO 加以改进。GRPO 在这里现实可期的上限是提升 +6 到 +8 个百分点。
- 在投入 GPU 小时数之前,先检查奖励提升空间。如果大多数组都全部答对(GSM8K 基础模型得分为 90.5 percent),组相对优势就会降至零,GRPO 也就没有梯度。启动 GRPO 训练前,先确认存在提升空间(pass@k >> pass@1)。
清理资源
为避免持续产生费用,请先删除工作负载资源,再删除底层基础设施:
- Delete the training and inference pods and jobs:
kubectl delete hyperpodpytorchjob lora-hyperpod-elastic --ignore-not-found kubectl delete pod grpo-single inference-base inference-trained inference-grpo \ eval-grpo fsx-storage-manager --ignore-not-found - 缩减 Amazon SageMaker HyperPod 集群或其节点组,或将其删除。
- 导出要保留的检查点后,删除 Amazon FSx for Lustre 文件系统。
- 删除用于训练数据或检查点归档的任何 Amazon Simple Storage Service (Amazon S3) 存储桶或对象。
结论
我们展示了如何在 Amazon SageMaker HyperPod 上对 GPT-OSS-20B 进行微调以实现多语言推理,以及如何在 SFT 和 GRPO 之间做出选择。SFT 完成了大部分工作:推理语言的表现从 22 percent 提升到 100 percent。在存在提升空间的情况下,GRPO 在此基础上带来了实际但有限的改进(回答正确率从 62 percent 提升到 70 percent)。平行开展的 Qwen2.5-7B 对照实验也证实了这一模式。在仍有改进空间的多语言推理任务上,GRPO 带来了 +6 percent 的提升;而在准确率已达峰值(90.5 percent)的 GSM8K 上,GRPO 没有带来增益。
决策框架:
- 模型完全不会的行为:使用 SFT。
- 模型偶尔能做到且仍有提升空间的行为:先用 SFT,再用 GRPO,以进一步提升几个百分点。
- 模型已达到最高准确率,或目标的基础概率为零:GRPO 无济于事。
如需亲自尝试,请逐步运行 awsome-distributed-ai 存储库中的测试用例。有关 Amazon SageMaker HyperPod 的更多信息,请参阅服务详情页面和 Amazon SageMaker HyperPod 文档。有关在 Amazon SageMaker HyperPod 上使用 Ray 的操作演示,请参阅相关文章 使用 Ray 和 Amazon SageMaker Studio 在 Amazon SageMaker HyperPod 上运行分布式训练。该链接将在相关文章发布后添加。欢迎在评论区分享您的结果。
作者简介

Mijanur Palash
Mijanur 是 AWS AI/ML 基础设施团队的专家解决方案架构师。他专注于面向汽车、制药和生成式 AI 客户的 Amazon SageMaker HyperPod 分布式训练和强化学习工作负载。工作之余,Palash 喜欢徒步和摄影。

Mark Vinciguerra
Mark 曾任 AWS 生成式 AI 全球专家解决方案架构师,专注于 Amazon SageMaker HyperPod 上的分布式训练和推理。他与战略客户合作,围绕 EKS 和 Slurm 编排开展大规模基础模型工作负载,并为 HyperPod、Ray 和 SageMaker Unified Studio 贡献参考架构和研讨会。
来源:AWS Machine Learning Blog · aws.amazon.com