使用 Strands Agents 构建自适应智能体框架
Adaptive agentic intelligence framework using Strands Agents
AWS 介绍了使用 Strands Agents 构建自适应智能体框架(AAIF)的方法,通过本地小语言模型处理常规请求,并将复杂分析路由至 Amazon Bedrock。文章以 IoT 监控为例,展示了本地遥测与图像分析工具、云端专家分析工具,以及根据请求复杂度进行路由的实现。文中还介绍了边缘、混合和纯云部署方式,并说明如何通过 MCP 服务器集中共享工具。
文章以 IoT 监控示例拆解本地与云端模型的分层路由,并给出边缘、混合和纯云部署配置,便于参考其架构取舍。
构建 AI 智能体的组织面临一个共同挑战:无论是常规状态检查还是复杂分析,每个请求通常都会被路由到同一个大型、昂贵的模型。这种“一刀切”的方法会推高 API 成本、带来不可预测的延迟,并使离线运行成为不可能。即使是可以在本地解决的常规查询,最终也需要与云端托管的大型语言模型 (LLM) 完成一次完整的网络往返。
自适应智能体智能框架 (AAIF) 由 Strands Agents 构建,采用了不同的方法。AAIF 不会将所有请求都路由到同一个大型模型,而是使用小型语言模型 (SLM) 在本地处理常规任务。更复杂的请求则通过 Amazon Bedrock 路由至云端托管模型。这种方法以 NVIDIA 的 Belcak 等人提出的研究观点为基础。他们认为,小型语言模型“对于智能体系统中的许多调用而言,能力足够强大、天生更适合,而且必然更经济”。该框架基于 Strands Agents 构建,展示了智能模型编排如何在降低成本的同时,保持本地操作的低延迟。
在本文中,我们将介绍 AAIF 的关键组件:通过 Ollama 使用本地 SLM,并通过 Amazon Bedrock 使用云端模型。我们以物联网 (IoT) 监控场景作为参考实现。
解决方案概述
如图 1 所示,AAIF 将 AI 处理分为三层,每一层都针对不同类型的任务进行了优化:
- 智能编排使用轻量级 SLM (llama3.2:1b) 作为决策层。该编排器对传入请求进行分类,并将其路由到相应的处理层,而无需硬编码规则。
- 本地处理通过 Ollama 使用在本地硬件上运行的 SLM,处理设备遥测数据检索和图像分析等常规任务。这些任务可低延迟完成,且不依赖云端。
- 云端处理通过 Amazon Bedrock 中的前沿模型执行复杂的模式分析和战略建议。这些请求需要更广泛的上下文和多步推理,而 SLM 无法可靠地提供这些能力。
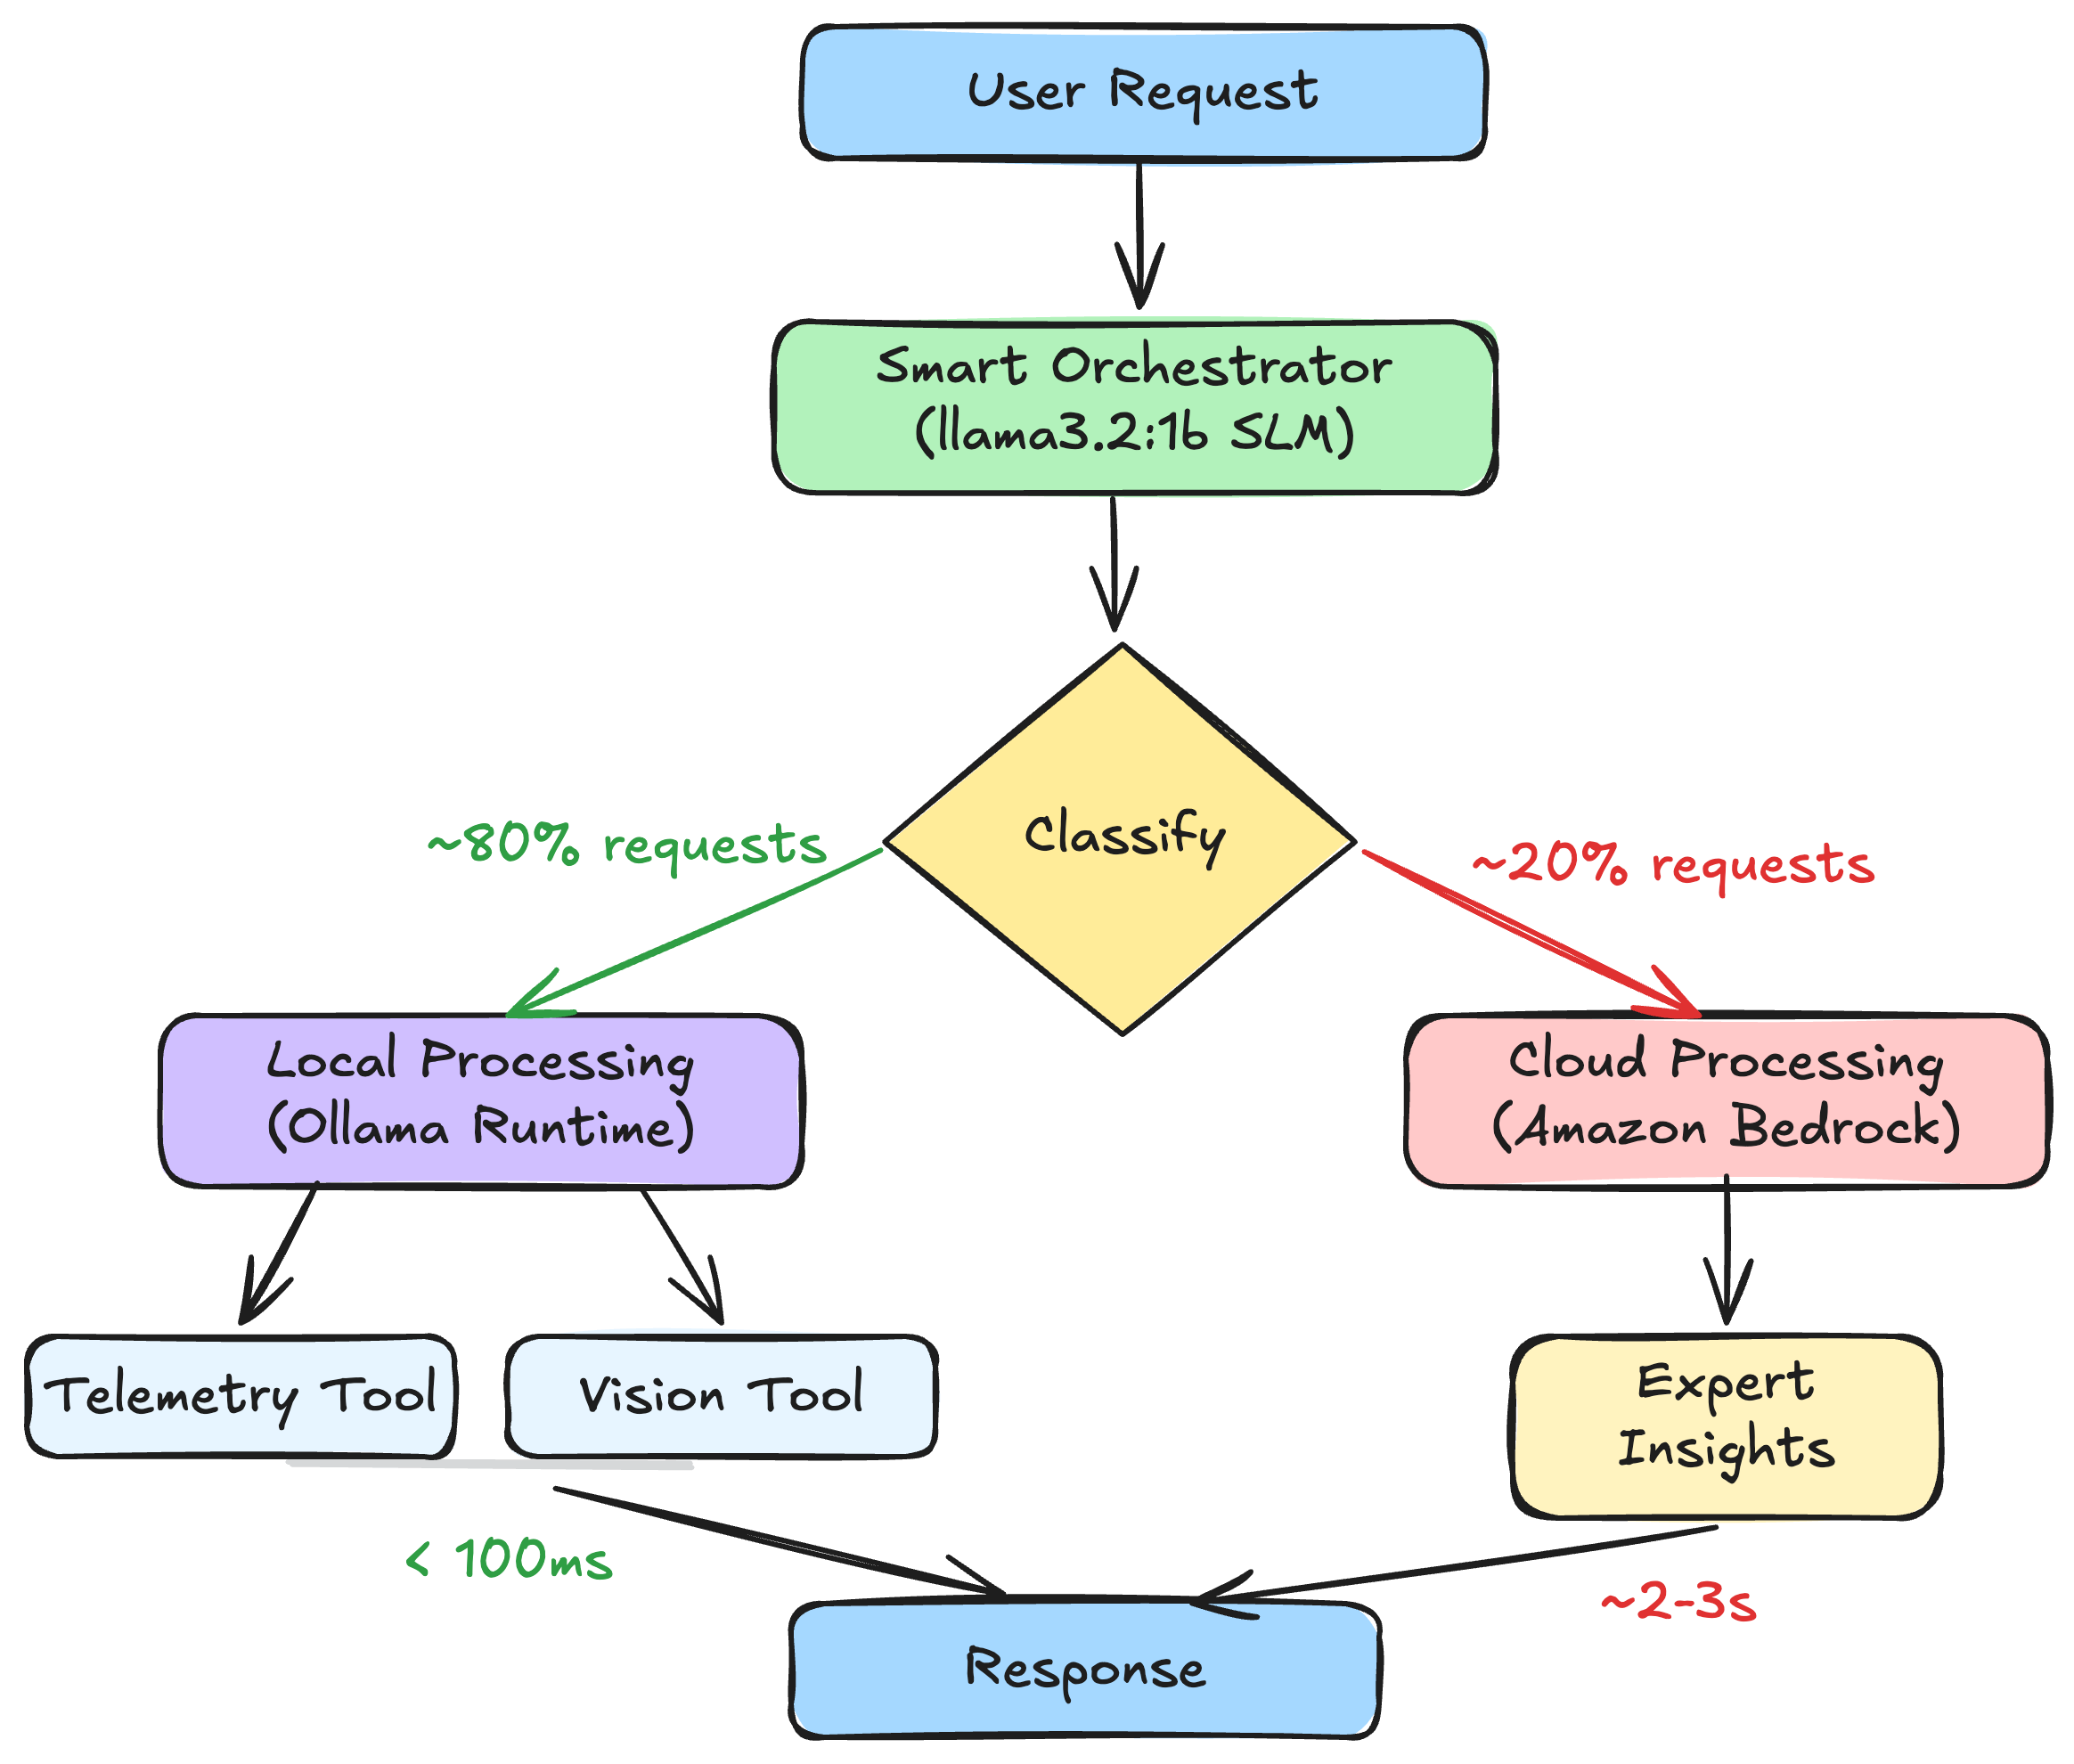
图 1:AAIF 的三个处理层:智能编排、本地处理和云端处理
图 1 展示了完整的 AAIF 系统架构。Strands 智能体位于中心,连接到一个 Ollama 运行时,该运行时承载着拥有 1B 参数的编排器模型和视觉模型。该智能体提供三个工具:get_device_telemetry 用于检索本地传感器数据,analyze_camera_feed 通过 llama3.2-vision 执行设备端视觉处理,而 get_expert_insights 则通过 boto3 调用 Amazon Bedrock 进行复杂分析。传入的用户请求会经过 SLM 编排器,由其对每个请求进行分类,并根据任务复杂度将请求分派给本地工具或云端端点。
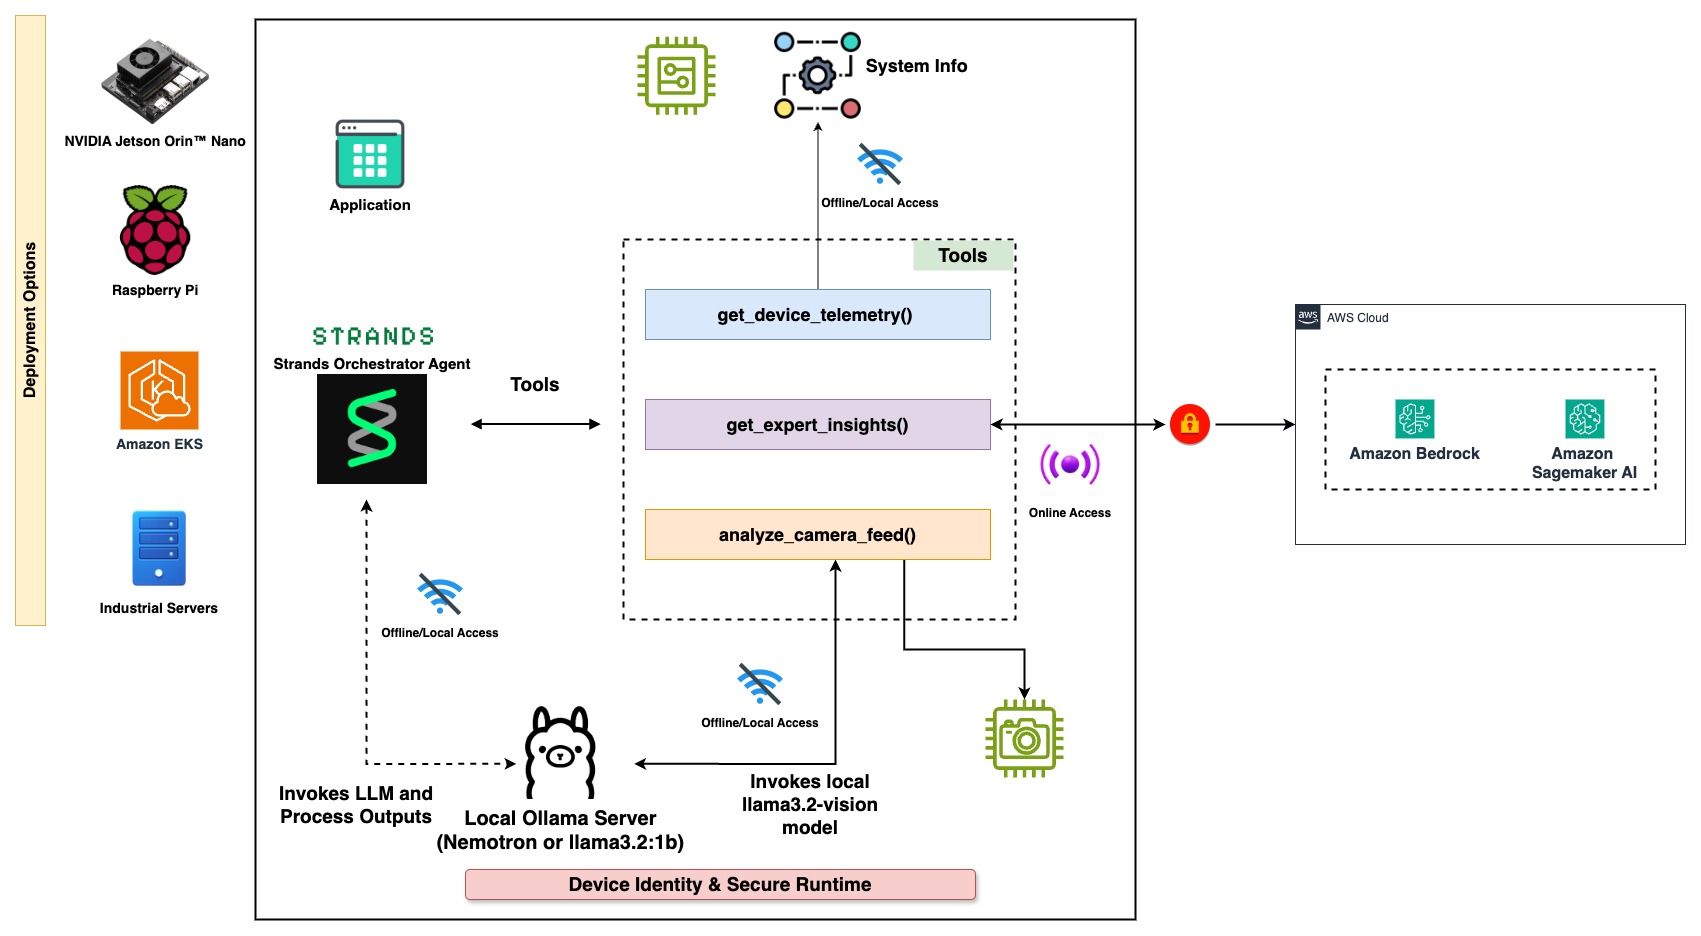
图 2:AAIF 完整系统架构,展示 Strands 智能体、Ollama 运行时、工具集成和 Amazon Bedrock 连接
该框架会适应你的部署限制,而不是要求你围绕它重构基础设施。这种架构既可以运行在内存为 8 GB 的 Raspberry Pi 等边缘设备上,也可以部署在所有推理请求都发送到 Amazon Bedrock 的完整云环境中,或部署在结合本地速度与云端推理能力的混合环境中。其灵活性源于将路由逻辑(SLM 编排器)与处理工具分离;你可以根据可用硬件和网络连接情况,独立替换或重新配置这些工具。
先决条件
完成本指南前,请确保具备以下条件:
- 一个 AWS 账户。
- 已在所需区域配置 Amazon Bedrock 模型访问权限。
- 已安装 Python 3.10+。
- Ollama installed with the following models pulled:
ollama pull llama3.2:1b(编排器)。ollama pull llama3.2-vision(视觉分析)。
- 已安装 Strands Agents:
pip install strands-agents strands-agents-tools。 - 已配置带有适当凭证的 AWS 命令行界面 (AWS CLI)。
- 已安装 Boto3:
pip install boto3。
设置环境
创建项目目录并启动 Ollama 服务器:
mkdir aaif-demo && cd aaif-demo
ollama serve
拉取所需模型:
ollama pull llama3.2:1b
ollama pull llama3.2-vision
创建一个名为 aaif_agent.py 的文件,并添加以下组件。
实现本地处理工具
Strands Agents 使用 @tool 装饰器来定义智能体可调用的功能。首先创建用于本地处理的工具。
第一个工具用于获取设备遥测数据。在生产环境中,该工具会连接到实际的 IoT 传感器。本指南使用模拟设备数据:
from strands import Agent, tool
import random

DEVICE_TELEMETRY = {
    "sensor-001": {
        "device_type": "Temperature Sensor",
        "location": "Building A - Floor 2",
        "temperature": 72.5,
        "humidity": 45.2,
        "status": "normal"
    },
    "camera-001": {
        "device_type": "Security Camera",
        "location": "Main Entrance",
        "fps": 30,
        "resolution": "1080p",
        "status": "recording"
    },
    "hvac-001": {
        "device_type": "HVAC Controller",
        "location": "Building A - Central",
        "set_temp": 71.0,
        "current_temp": 72.5,
        "mode": "cooling",
        "status": "active"
    }
}

@tool
def get_device_telemetry() -> str:
    """Retrieve current telemetry data from connected IoT devices."""
    device_id = random.choice(list(DEVICE_TELEMETRY.keys()))
    device_data = DEVICE_TELEMETRY[device_id]

    report = f"Device: {device_id} ({device_data['device_type']})\n"
    report += f"Location: {device_data['location']}\n"
    report += f"Status: {device_data['status']}\n"
    for key, value in device_data.items():
        if key not in ['device_type', 'location', 'status']:
            report += f"{key}: {value}\n"
    return report
第二个工具使用本地 SLM 进行视觉分析。llama3.2-vision 模型完全在本地硬件上运行,这意味着敏感的摄像头画面不会离开设备:
import ollama

@tool
def analyze_camera_feed(image_path: str) -> str:
    """Analyze visual data from cameras using local vision model."""
    stream = ollama.chat(
        model='llama3.2-vision',
        messages=[{
            'role': 'user',
            'content': 'Describe this image in one sentence. '
            'What are the 3 most important things you see?',
            'images': [image_path]
        }],
        stream=True,
    )

    full_response = ""
    for chunk in stream:
        chunk_content = chunk['message']['content']
        print(chunk_content, end='', flush=True)
        full_response += chunk_content

    return f"Object Detection Report:\n{full_response}"
实现云端处理
对于需要更广泛推理能力的复杂分析,可以创建一个调用 Amazon Bedrock 的工具。只有当编排器判断本地模型无法处理请求时,才会调用此工具:
import boto3

@tool
def get_expert_insights(context_data: str, question: str) -> str:
    """Get advanced analysis and expert recommendations
    for complex questions via Amazon Bedrock."""
    client = boto3.client("bedrock-runtime", region_name="us-east-1")

    conversation = [
        {
            "role": "user",
            "content": [
                {"text": f"Context: {context_data}\n\nQuestion: {question}"}
            ],
        }
    ]

    response = client.converse(
        modelId="<<model_id>", //Refer model id [details](https://docs.aws.amazon.com/bedrock/latest/userguide/foundation-models-reference.html)
        messages=conversation,
        inferenceConfig={
            "maxTokens": 512,
            "temperature": 0.5,
            "topP": 0.9
        }
    )

    response_text = response["output"]["message"]["content"][0]["text"]
    return f"Expert Analysis:\n{response_text}"
使用智能编排配置 Strands 智能体
AAIF 的核心是 Strands 智能体配置。该智能体使用本地 SLM (llama3.2:1b) 作为编排器。Strands Agents 支持多个模型提供商;此处我们使用 Ollama 提供商在本地运行编排器:
from strands.models.ollama import OllamaModel

model = OllamaModel(
    model_id="llama3.2:1b",
    host="http://localhost:11434",
    params={
        "max_tokens": 300,
        "temperature": 0.3,
    },
)

system_prompt = """You are a monitoring assistant for operational facilities.
You have access to device telemetry tools, analysis capabilities,
and expert insights to help monitor operations effectively.

When users ask for:
- Device status or telemetry: use get_device_telemetry
- Image or data analysis: use analyze_camera_feed
- Expert advice or complex questions: use get_expert_insights

Always return the complete tool results directly to the user."""

agent = Agent(
    model=model,
    system_prompt=system_prompt,
    tools=[
        get_device_telemetry,
        analyze_camera_feed,
        get_expert_insights,
    ],
)
由 SLM 驱动的编排器会分析每个请求,并将其路由到适当的工具,而无需硬编码关键词匹配。路由过程依赖模型对请求的理解:
| 请求 | 路由 | 延迟 |
| “检查设备状态” | 本地 SLM | 低(本地推理) |
| “分析此图像” | 本地视觉 AI | 低(本地推理) |
| “你推荐哪些优化策略?” | 云端(Amazon Bedrock) | 较高(网络往返) |
表 1:本地推理与云端推理的请求、路由和延迟估算
运行智能体
配置好智能体后,你可以直接与其交互:
# Local processing - device telemetry
response = agent("What's the current status of our devices?")
print(response)

# Local processing - vision analysis
response = agent("Analyze the camera feed from camera-001")
print(response)

# Cloud processing - complex analysis
response = agent(
    "Based on current telemetry patterns, "
    "what optimization strategies do you recommend?"
)
print(response)
智能体会自动对每个请求进行分类,并将其路由到适当的处理层。无需设置显式路由规则。
适应不同的部署场景
通过更改模型配置,AAIF 架构可以适应不同的基础设施需求:
当工作负载完全在云端运行且没有可用的边缘硬件时,可将 Ollama 模型配置替换为 Amazon Bedrock,以处理所有请求。这样,所有请求都会通过托管云端推理进行处理,无需本地 GPU 资源即可实现自动扩缩。对于连接稳定且延迟低、又没有数据驻留限制的团队,此配置最为适用:
from strands.models import BedrockModel

model = BedrockModel(
    model_id="<<model_id>", //Refer model id [details](https://docs.aws.amazon.com/bedrock/latest/userguide/foundation-models-reference.html)
    region_name="us-east-1"
)
混合配置保留了本地 SLM 编排器,同时为超出本地模型能力的请求添加云端模型。这是本演练中展示的默认 AAIF 配置。它适用于大多数请求都足够常规、可以在本地解决,但有些请求需要更大型模型进行更广泛推理的环境。对于约 80% 不会调用付费 API 端点的流量,可以节省成本。
对于完全隔离网络或有严格数据主权要求的环境,可将云端工具替换为更大型的本地模型,并在设备上运行所有处理。运行在内存充足的硬件上的 3B 参数模型,可以处理较复杂的任务,而这些任务原本会由 1B 编排器升级处理。代价是处理最难查询时的推理深度会降低,但好处是数据不会离开本地环境:
model = OllamaModel(
    model_id="llama3.2:3b", # Larger local model for complex tasks
    host="http://localhost:11434",
)
展望:使用 MCP 服务器集中调用工具
本文中的实现使用了直接在代理代码中定义的本地工具调用。对于多个代理需要跨服务共享工具的生产部署,可将这些工具作为模型上下文协议(MCP)服务器公开。MCP 提供了用于发现和调用工具的标准化接口,因此你可以集中管理工具,并在不同代理和环境之间重复使用工具。在图 3 中,我们展示了如何将 AAIF 工具转换为 MCP 服务器,以实现分布式的集中工具调用。
如图 3 所示,在分布式配置中,设备 1 充当编排中心,运行带有 SLM 路由器和本地遥测工具的 Strands 代理。它通过 MCP 协议连接到设备 2,后者运行搭载 llama3.2-vision 的边缘视觉处理服务器。设备 3 充当连接到 Amazon Bedrock 的云分析网关。从编排器的角度来看,所有远程工具都表现为本地函数调用,因为 MCP 传输层会透明地处理序列化和网络通信。
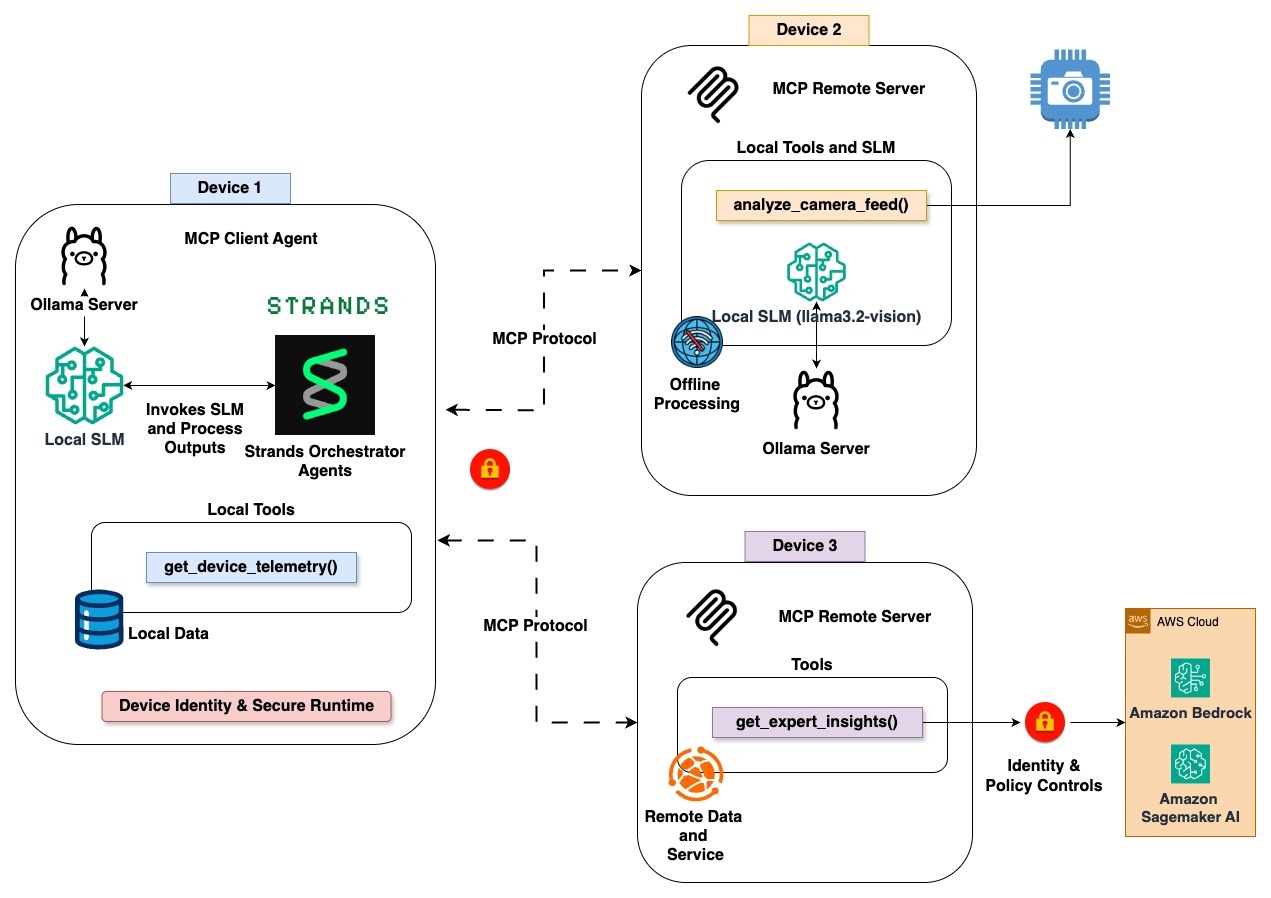
图 3:借助 MCP 服务器实现分布式智能
清理
为避免产生后续费用,请完成以下清理步骤:
- 禁用 Amazon Bedrock 模型访问权限:打开 Amazon Bedrock 控制台,选择 模型访问权限,然后撤销对 Amazon Nova Lite 的访问权限。详细步骤请参阅《Amazon Bedrock 用户指南》中的 管理模型访问权限。
- Stop the Ollama server and remove models to free local disk space (approximately 2 GB):
ollama stop ollama rm llama3.2:1b ollama rm llama3.2-vision - Delete the project directory if you no longer need the sample code:
rm -rf aaif-demo
结论
我们展示了如何使用 Adaptive Agentic Intelligence Framework 和 Strands Agents 构建经济高效的 AI 代理。通过将常规请求路由到本地 SLM,并将 Amazon Bedrock 上的云端模型留给复杂分析,AAIF 可以帮助降低 API 成本,同时保持常规操作的低延迟。
在生产环境中运行此模式之前,请为云端推理路径添加负责任的 AI 控制措施,因为这类请求会携带工具输出、检索到的数据和用户输入。你可以为 Strands BedrockModel 配置护栏 ID 和版本,从而附加 Amazon Bedrock Guardrails。它随后会应用有害类别内容过滤器、提示注入过滤器和上下文依据检查,以阻止缺乏源数据支持的响应。若要对本地 SLM 层应用相同的策略,请对其输入和输出调用独立的 ApplyGuardrail API。这样,无论由哪个模型处理,每个请求都遵循统一的安全标准。
这种架构模式不仅适用于 IoT 监控。医疗机构可以在本地运行患者监控,同时将诊断支持请求路由到云端模型。金融服务公司可以在本地处理交易,并将云端容量留给风险分析。制造团队可以在边缘运行质量控制视觉模型,同时将优化请求发送到云端。
要详细了解如何使用 Strands Agents 构建代理,请访问 Strands Agents 文档。有关可用基础模型的信息,请参阅 Amazon Bedrock。
作者简介

Nitin Eusebius
Nitin 是 AWS 的首席解决方案架构师,专注于生成式 AI 和智能体系统。他致力于帮助客户在云端和边缘环境中构建智能且经济高效的 AI 解决方案。

Mani Khanuja
Mani 是 AWS 的首席解决方案架构师,专注于 AI/ML 和生成式 AI。她帮助客户采用可扩展的 AI 解决方案,并热衷于推动负责任的 AI 实践。
来源:AWS Machine Learning Blog · aws.amazon.com