AWS 发布 Amazon SageMaker AI training session APIs,支持自定义训练循环并由托管 GPU 执行
Write your own training loop — without managing GPUs — with Amazon SageMaker training session APIs
AWS 扩展 Amazon SageMaker AI 的无服务器模型定制服务,推出 training session APIs:用户可用 Python 编写训练循环,SageMaker AI 在托管 GPU 上执行采样、梯度计算和检查点操作,并负责分布式执行与故障恢复。
训练 session APIs 将训练算法控制权交给用户、把 GPU 运维交由 SageMaker AI,并按处理的 token 计费;文中以 GRPO 和代码竞赛任务展示了具体用法与指标。
如今,微调大型语言模型(LLM)通常意味着要在训练循环控制能力与运维简便性之间做出取舍。使用全托管服务时,你只需选择基础模型、提供数据和超参数,其余工作都由服务负责;如果标准的预置方案适合你的问题,这种方式效果很好。托管程度较低的服务能让你拥有更多控制权,但你也需要管理更多底层基础设施和训练框架。有时,标准方案并不足够:你可能需要为监督微调(SFT)定制损失函数或数据课程、自定义偏好优化方法、强化学习(RL)奖励函数,或上周刚发布的对齐算法。一旦你需要自行设计训练流程,就得承担相应的基础设施工作,才能获得算法上的自由。
如今,Amazon SageMaker AI 中的无服务器模型定制功能新增了训练会话 API,通过将抽象边界下移一层,消除了这种取舍。它们抽象掉的不是算法,而是计算资源。forward_backward()、optim_step() 和 sample() 等操作会变成 SageMaker API 调用,你可以将其组合成技术所需的任意流程:SFT、偏好优化、RL,或其他新方法。这些调用面向一个实时、有状态的会话,因此模型会在各步骤之间持续加载在 GPU 上,你可以根据需要对其进行任意次数的调用。该服务负责运行时设置、分布式执行、梯度同步、故障恢复、租户隔离,以及大规模运行 GPU 的运维工作。你编写训练循环,SageMaker AI 负责运行基础设施。
我们还将发布SageMaker 训练会话 cookbook,其中包含一组可直接运行的 SFT 和 RL 配方,你可以将其用作编写自定义训练循环的蓝图。
本文将介绍编程模型和三个 SDK 客户端,并说明训练会话 API 在 SageMaker AI 的模型训练与定制选项中所处的位置。随后,我们将剖析一个针对小学数学题(GSM8K)的最简 RL 循环,展示这些操作如何协同工作;最后介绍 cookbook 中的真实工作负载:针对竞赛编程题进行强化学习,通过运行单元测试来评估生成的代码。
什么是 SageMaker AI 训练会话 API?
借助 SageMaker AI 训练会话 API,你可以通过本地计算机上的 Python 进程驱动实时的 GPU 支持会话。你调用相关操作,SageMaker AI 则在托管加速器上运行这些操作;加速器中已加载你所选的基础模型及其低秩适配(LoRA)适配器。你无需预先准备描述整个作业的配置文件,也无需创建集群。你可以通过代码交互式地控制每个步骤中发生的事情,从而快速迭代和调试。
职责划分如下:
| 你专注于 | 你编写 | SageMaker AI 负责 |
| 你的数据、RL 环境、智能体和算法 | 一个 Python 训练循环,在需要 GPU 的步骤中调用 forward_backward()、optim_step() 和 sample() 等操作 |
GPU 分配、模型和 LoRA 加载、分布式执行、故障恢复、检查点存储、安全性 |
API 围绕 SageMaker Python SDK 中的三个客户端组织,这些客户端按顺序创建。ServiceClient 保存平台级设置(执行角色、模型包组、Amazon Simple Storage Service (Amazon S3) 输出位置,以及可选的 AWS Key Management Service (AWS KMS) 密钥和虚拟私有云 (VPC) 配置;你也可以按会话覆盖这些设置),并启动会话。ServiceClient 实例化一个 TrainingClient(用于训练和检查点操作,例如 forward、forward_backward、optim_step 和 save_weights_for_sampler),后者又会实例化一个 SamplingClient(sample 和 compute_logprobs,用于在 rollout 和评估期间进行生成和评分)。每次 API 调用都对应循环中的一个操作。活动会话还会提供兼容 OpenAI 的聊天补全端点,因此现有的 OpenAI 客户端代码可以从中采样。
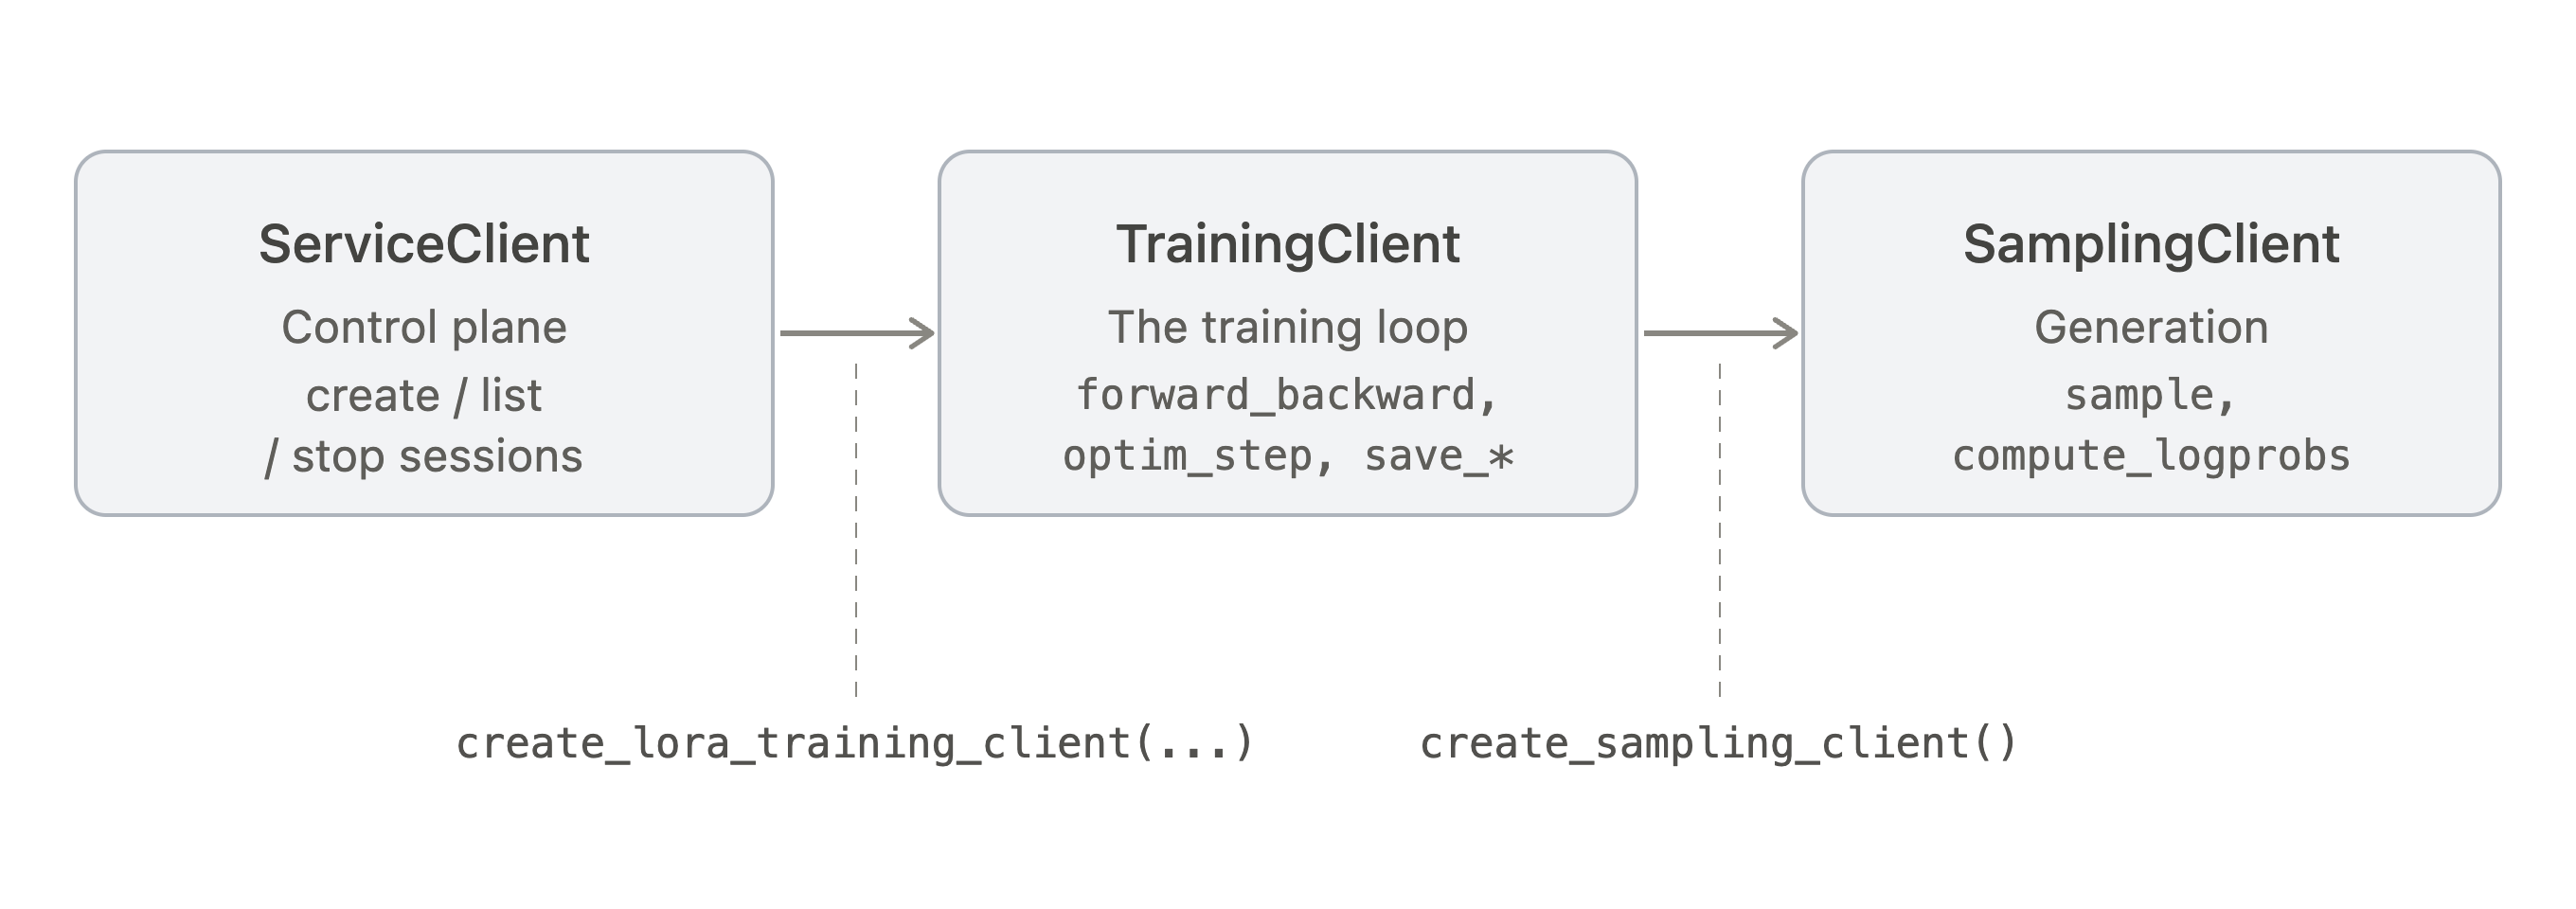
图 1:用于训练会话 API 的 SageMaker Python SDK 客户端层级
对于强化学习,循环具有鲜明的结构。下图展示了一个训练步骤以及各部分的运行位置:绿色步骤调用服务托管 GPU 上的 API;紫色步骤(即你的循环控制和奖励逻辑)则在你的机器上运行。
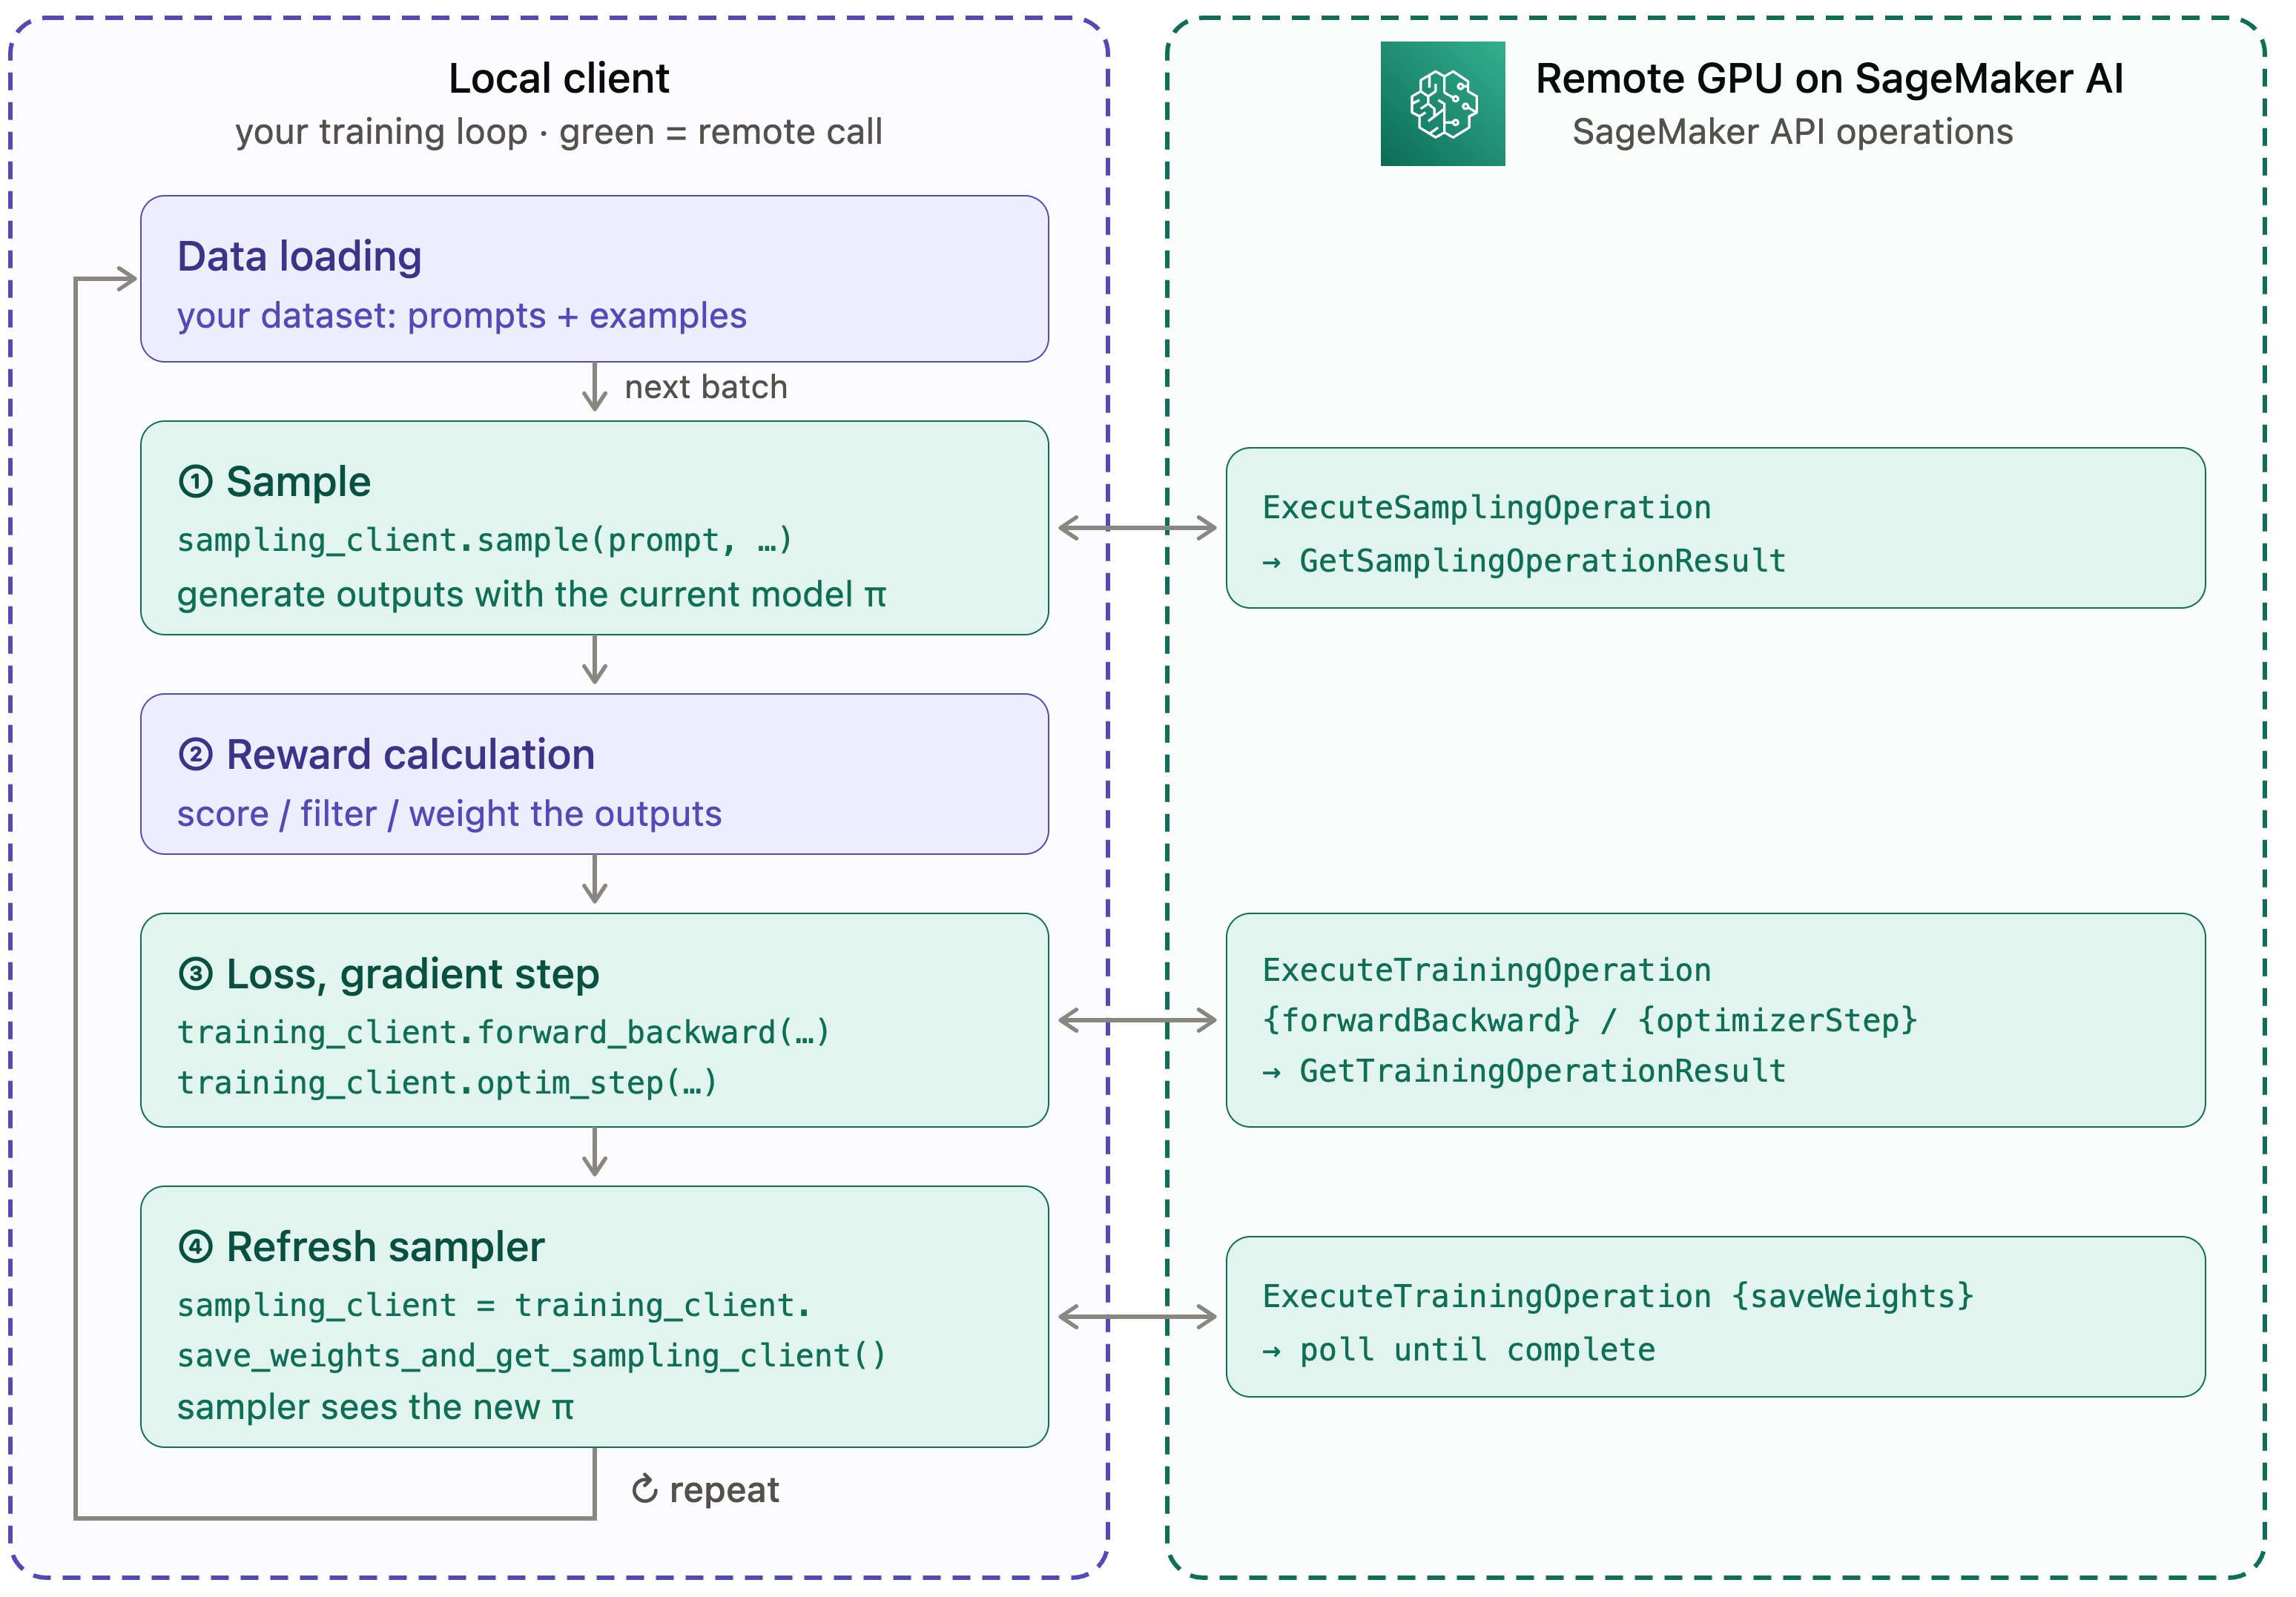
图 2:一个训练步骤,其中采样、梯度和检查点操作在托管 GPU 上运行,循环控制和奖励逻辑在你的机器上运行
每一步都会加载一批提示,并在 GPU 上 (1) 从当前模型采样。随后,你的 Python 代码会 (2) 对这些输出进行评分:验证器、奖励模型调用、测试框架,或任何你能用代码表达的内容。(3) forward_backward 和 optim_step 会将分数转换为 GPU 上的梯度更新,而 (4) save_weights_and_get_sampling_client() 会刷新采样器,让下一步从更新后的模型进行采样。
数据、循环控制和奖励由你负责;SageMaker AI 则运行受 GPU 限制的采样、梯度和检查点操作。同样的基本操作也适用于监督微调 (SFT) 和其他 LLM 训练技术。对于 SFT,省去采样和奖励步骤,并在带标签的示例上调用 forward_backward,使用 cross_entropy 损失。
适用对象以及它在 Amazon SageMaker AI 中的定位
当你需要快速迭代并灵活选择算法(例如自定义损失、新的 RL 奖励信号或多阶段流水线),但又不想自行预置或运维 GPU 基础设施时,训练会话 API 是合适的起点。
使用费用按处理的 token 数计费,因此只需为循环实际消耗的计算付费。如果奖励函数在你的机器上花 10 秒为一批数据评分,那么这段时间不会产生 GPU 计费。与按 GPU 小时计费相比,这有两个实际优势。首先,没有 GPU 空闲成本:奖励计算、数据加载、日志记录和调试都不计入计费时间,只有调用受 GPU 限制的操作时才会收费。其次,成本随数据集和生成量变化,而非随实际运行时间或集群规模变化,因此更容易预测支出,也更容易比较实验。对于本地计算量较大的工作负载,例如复杂的奖励模型、多工具智能体 rollout 或人在回路评估,与在整个会话期间预留 GPU 相比,节省的费用可能相当可观。
训练会话 API 面向工作由训练算法定义、而不仅仅是数据集定义的团队。由于您可以自行组合训练循环,同一组基本操作既支持在带标签数据上使用 cross_entropy 损失的监督微调 (SFT),也支持使用 ppo、importance_sampling 或 cispo(GRPO、PPO 和其他组相对方法)的强化学习,以及基于相同组件构建的自定义目标,例如偏好优化或蒸馏。适用对象包括:
- 实施 RL 方法(GRPO、PPO、重要性采样变体)、自定义优势估计器或新目标的后训练和对齐研究人员。
- 进行监督微调或偏好优化的团队,如果他们需要非标准损失、数据课程或配置驱动配方无法表达的多阶段流水线。
- 需要自定义 rollout 逻辑、奖励塑形和课程的智能体及多轮 RL 构建者。
- 希望超越配置驱动微调、但不想承担 GPU 集群运维负担的机器学习 (ML) 工程师。
- 迁移现有训练循环代码的研究人员,因为基于操作的编程模型可直接映射到针对底层
forward_backward、optim_step和sampleAPI 编写的循环。
支持的基础模型以及各模型可用的 AWS 区域列于训练会话 API 文档中。
训练会话 API 在 Amazon SageMaker AI 中的定位
在 SageMaker AI 的模型定制选项中,训练会话 API 位于一个独特的位置:与完全托管的无服务器模型定制相比,它能让您大幅增加对训练算法的控制;与在Amazon SageMaker Training Jobs或Amazon SageMaker HyperPod上进行训练相比,它所需承担的运维责任则少得多。
| 选项 | 训练控制权 | 基础设施 |
| SageMaker 无服务器模型定制 – 托管式 API | 低 – 选择模型、配置可用超参数并提供数据 | 无服务器,无需选择实例 |
| SageMaker 无服务器模型定制 – SageMaker AI 训练会话 API | 高 – 编写训练循环并调用基本操作 | 无服务器,无需选择实例 |
| SageMaker Training Jobs | 完全 | 托管式临时任务,可选择实例类型 |
| SageMaker HyperPod | 完全 | 托管式持久集群,具备高级故障恢复功能 |
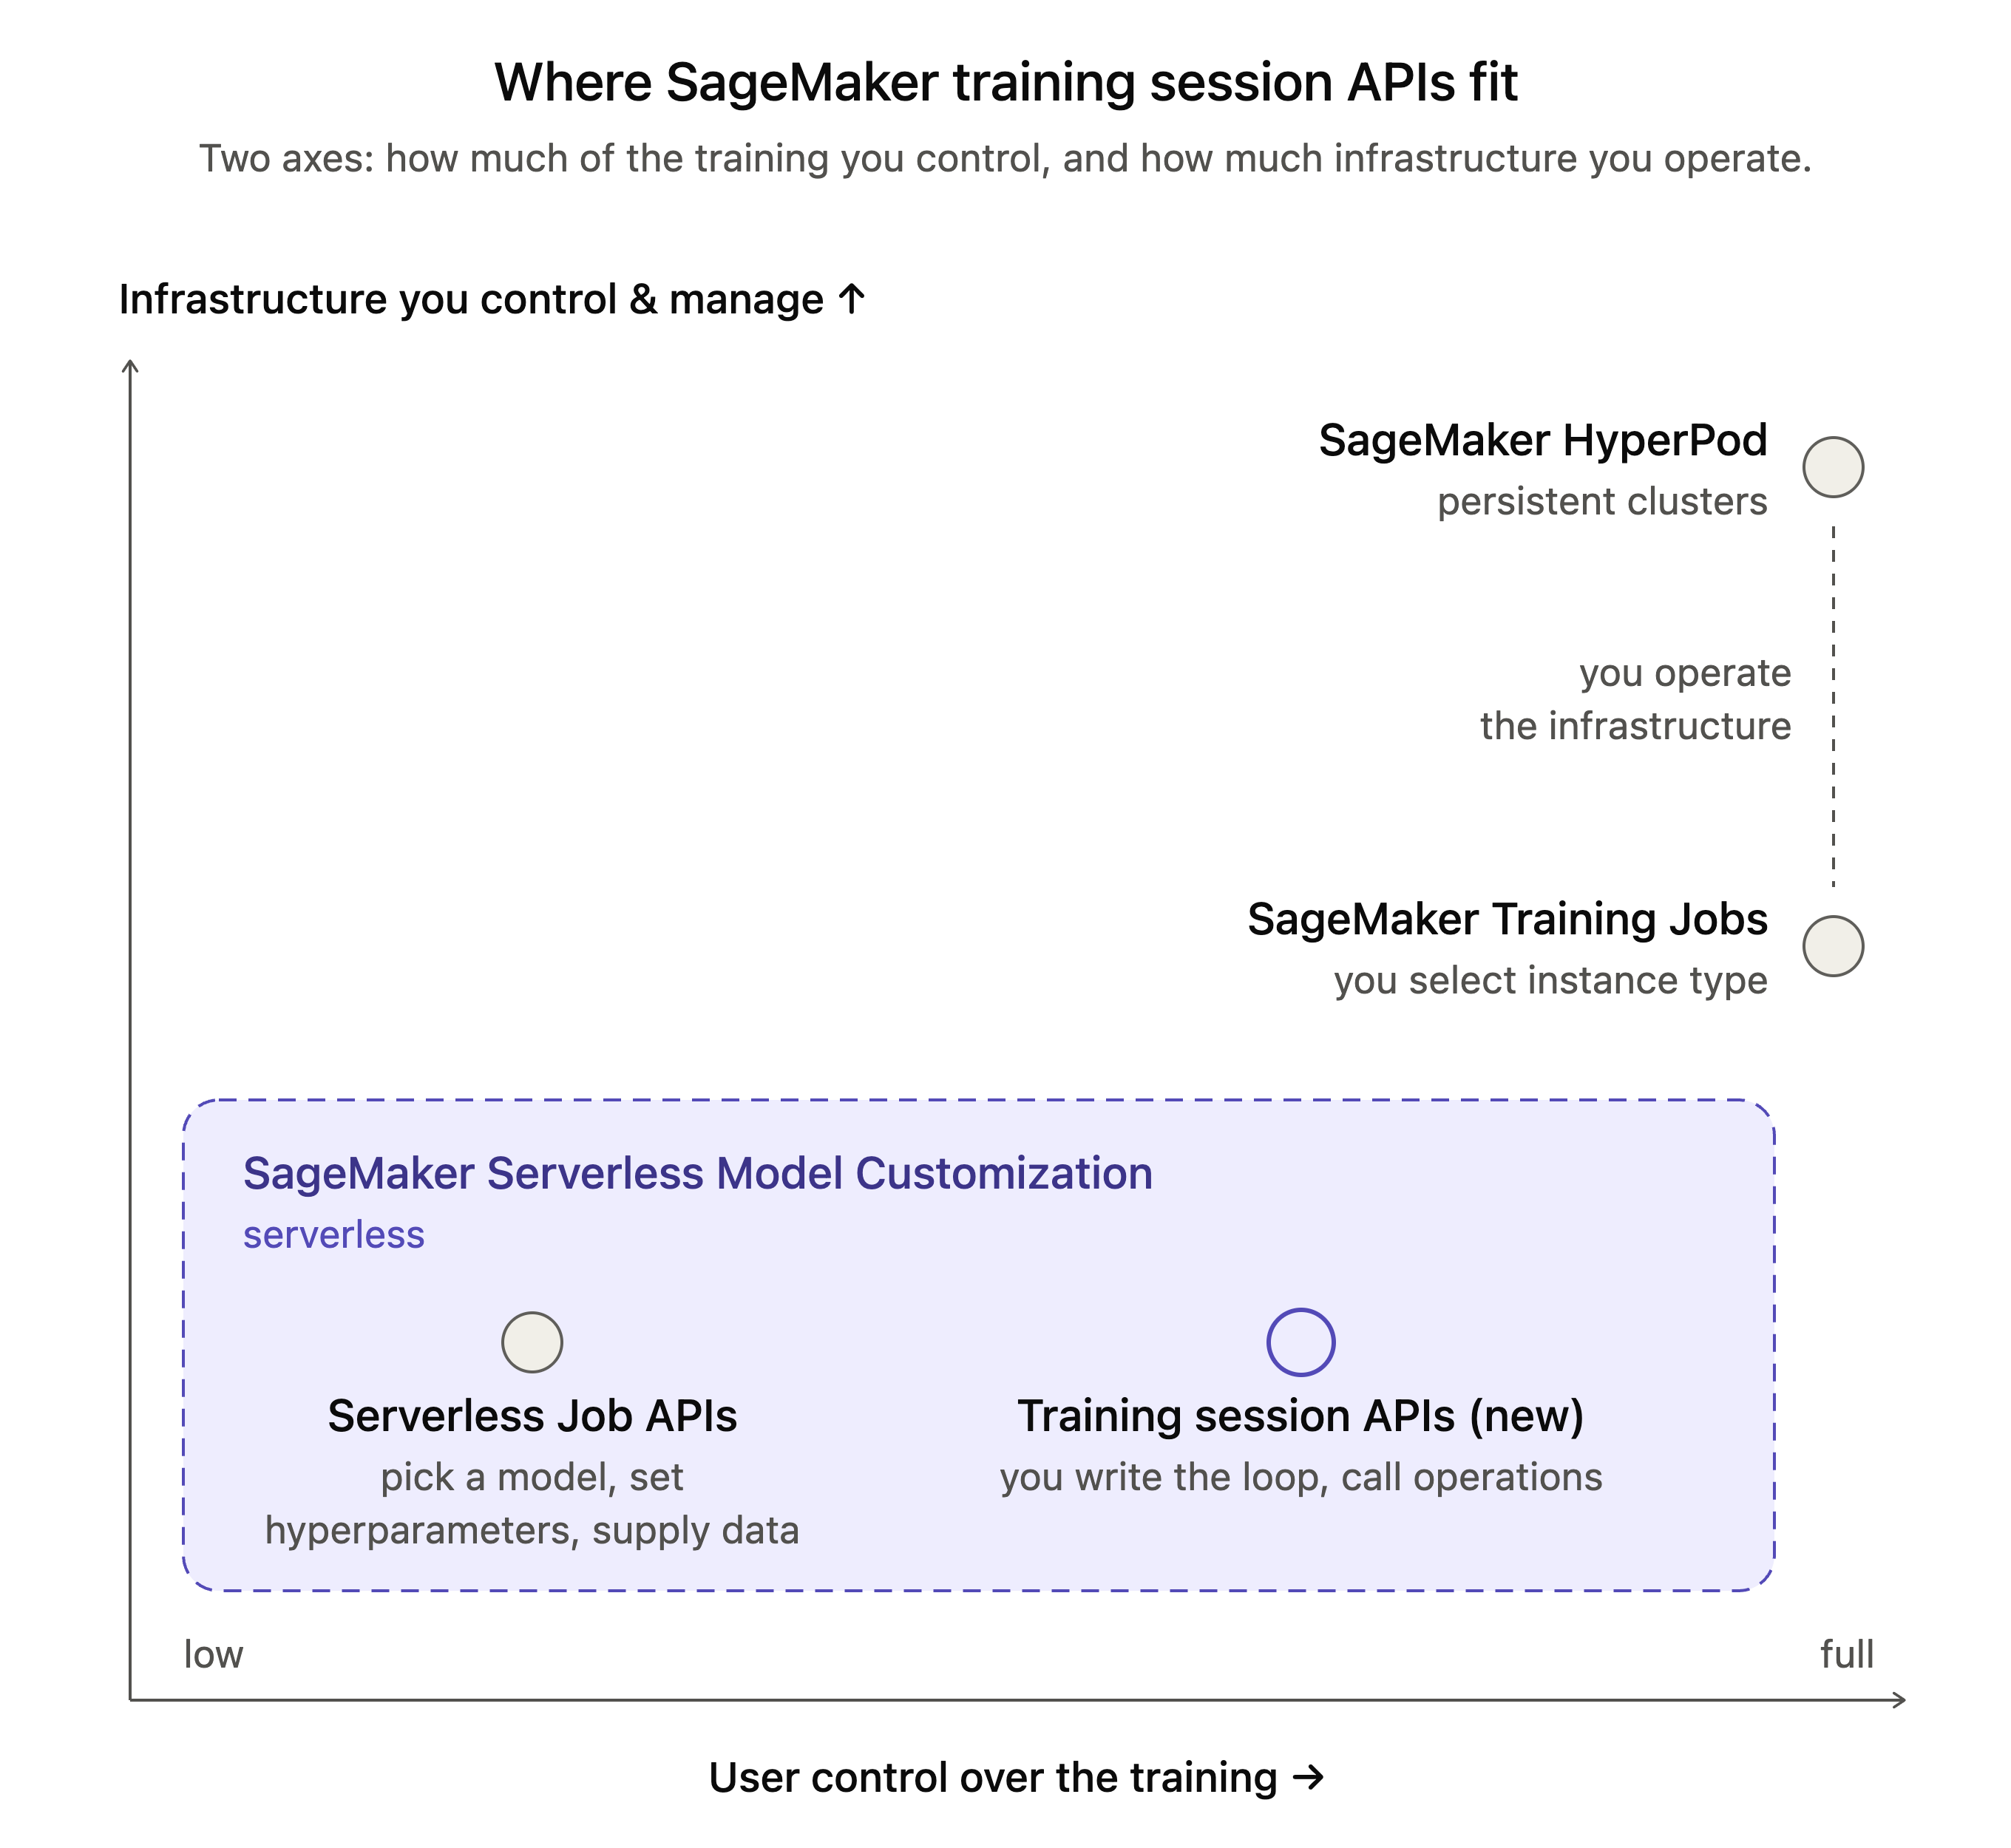
图 3:训练会话 API 在 SageMaker AI 模型定制选项中的定位
训练循环剖析:在数学问题上运行 GRPO
本节将拆解一个最简强化学习循环,展示各项操作如何协同工作。任务是GSM8K,这是一个包含约 8,500 道小学数学应用题的基准测试,每题都有一个数值答案,例如:
Natalia 在 4 月把夹子卖给了 48 位朋友,之后她在 5 月卖出的夹子数量是 4 月的一半。Natalia 在 4 月和 5 月总共卖出了多少个夹子? → 72
我们使用组相对策略优化 (GRPO) 为 OpenAI 的 GPT-OSS 20B 训练一个 LoRA 适配器:对于每个问题,模型会生成多个回答;每个回答都会根据正确性评分,优于组平均水平的回答会得到强化。完整且可运行的示例位于Amazon SageMaker 示例存储库中。
打开会话之前,请先完成文档中的先决条件。
打开会话
创建会话,然后从中获取分词器和一个 SamplingClient:
from sagemaker.train.training_session import ServiceClient, SamplingParams, AdamParams

svc = ServiceClient(role_arn=role, region=REGION)

training_client = svc.create_lora_training_client(
    "openai/gpt-oss-20b",                        # a name from svc.list_base_models()
    training_session_name=SESSION_NAME,
    rank=32, alpha=64,                           # LoRA rank and scaling factor
    model_package_group_arn=MODEL_PACKAGE_GROUP_ARN,
    s3_output_path=OUTPUT_S3_PATH,
)
tokenizer = training_client.get_tokenizer()
sampling_client = training_client.create_sampling_client()
定义奖励和优势
针对该任务的逻辑由两个在你的机器上运行的短函数组成:
def compute_reward(response_text, ground_truth):
    predicted = extract_answer(response_text)      # parse the number after "#### "
    return 1.0 if predicted == ground_truth else 0.0

def compute_advantages(rewards):
    rewards = np.array(rewards)
    advantages = rewards - rewards.mean()          # center within the group (the GRPO baseline)
    return advantages / (rewards.std() + 1e-8)     # normalize
循环
每一步都遵循图 2 所示的四个阶段。draw、build_prompt 和 build_training_datum 是示例中的简短辅助函数:
for step in range(NUM_STEPS):
    datums, pending = [], []
    # (1) sample K responses per question in one request each (GPU); returns a future right away
    for question, ground_truth in draw(PROMPTS_PER_STEP):          # data loading is local
        prompt = tokenizer.encode(build_prompt(question), add_special_tokens=False)
        pending.append((prompt, ground_truth, sampling_client.sample(
            prompt, num_samples=K,
            sampling_params=SamplingParams(max_tokens=512, temperature=0.7, top_p=0.9))))

    for prompt, ground_truth, future in pending:
        result = future.result()                                    # wait once the batch is in flight
        # (2) score each response, then center the rewards within the group (local)
        rewards = [compute_reward(tokenizer.decode(s.tokens), ground_truth) for s in result.sequences]
        advantages = compute_advantages(rewards)
        datums += [build_training_datum(prompt, s, a) for s, a in zip(result.sequences, advantages)]

    # (3) one gradient step over the batch (GPU); the optimizer step is sequenced behind it
    fwd_bwd_op = training_client.forward_backward(datums, loss_fn="ppo")
    optim_op = training_client.optim_step(AdamParams(learning_rate=1e-5))
    fwd_bwd_op.result(), optim_op.result()

    # (4) refresh the sampler so the next step's rollouts come from the updated policy (GPU)
    sampling_client = training_client.save_weights_and_get_sampling_client()

training_client.stop()
这个循环能够运行,有三个关键细节:
操作会返回 future。每个面向 GPU 的调用都会立即返回一个 APIFuture:请求会排队并由后台提交器发送,而 .result() 会等待结果。循环会先提交某一步的所有采样请求,然后再等待其中任何一个,因此整个批次会并发生成。训练操作会按调用顺序运行,因此可以在 forward_backward 完成之前提交 optim_step。
数据项包含损失函数所需的一切内容。build_training_datum 会打包提示词和回复 token、来自 sample() 的逐 token 对数概率、优势值,以及一个 weights 掩码,用来将提示词排除在损失计算之外。
检查点是模型包。每次保存都会在模型包组中注册一个版本,包括上述循环中的逐步采样器刷新。训练后,还会额外保存两次:一次添加用于部署的合并模型,另一次添加包含权重和优化器状态、可用于恢复训练的状态。
training_client.save_weights_for_sampler(merge_weights=True).result()   # merged, deployable model
training_client.save_state().result()                                   # resumable state (weights + optimizer)
要恢复训练,请从最新检查点启动一个新会话,并使用 create_training_client_from_state_with_optimizer。
运行中的会话会计入你的并发会话配额,直到你调用 stop() 或会话过期。因此,完成后请停止会话,包括在错误处理路径中停止;或者在 with 块中打开客户端。合并后的检查点可部署到实时端点。若要将检查点作为 LoRA 适配器提供服务,请参阅 cookbook 中的 部署笔记本。
在我们的示例运行中,对 40 道题进行 10 个训练步骤后,留出集准确率从 56 percent 提升到 75 percent。
真实场景工作负载:在竞赛编程任务上进行 RL
GSM8K 能清楚展示基本机制,但生产环境中的 RL 工作负载还涉及更多内容:更长的生成、多轮交互、外部评分器,以及足以让 GPU 保持繁忙的吞吐量。SageMaker 训练会话 cookbook 将这些工程工作封装为可复用的训练循环,并基于相同的操作构建。对于新的 RL 任务,你需要编写一个环境:模型会看到什么、答案如何评分,以及模型是否能进行下一轮交互。cookbook 负责批处理、聊天模板、优势估计、采样与训练的重叠执行、验证、支持恢复训练的检查点,以及逐步指标,并记录每次运行的配置,以便重复运行。code_rl 配方使用它来训练模型解决竞赛编程问题。
任务。题目来自 DeepCoder 数据集(训练集使用 PrimeIntellect、TACO 和 LiveCodeBench;测试集使用 Codeforces 和 LiveCodeBench)。模型会编写 Python 解法,并在你机器上的 SandboxFusion 容器中针对题目的单元测试运行。所有测试都通过时奖励为 1,否则为 0;如果回复中不包含代码块,则额外扣 0.1。
多轮工具使用。通过两轮交互,模型可以调用 check_solution 工具、读取测试结果,并在最终评分前修改答案。工具调用和结果会以模型原生的聊天格式呈现,因此模型接受训练时使用的 token 格式与推理时使用的格式相同。
该配方在最简循环的基础上增加了:
- 采样与训练的重叠执行:当训练器运行一个步骤时,轨迹生成工作器会继续生成。如果从旧策略采样的一组回复至多落后 k 个步骤,就会被使用;否则会重新排队,而
cispo损失会校正策略差异。 - 流式梯度计算:
forward_backward会在各个子批次完成时分组提交,而不是每个步骤只提交一次。 - 留出验证、检查点恢复和逐步指标,可选择发布到SageMaker 托管式 MLflow。
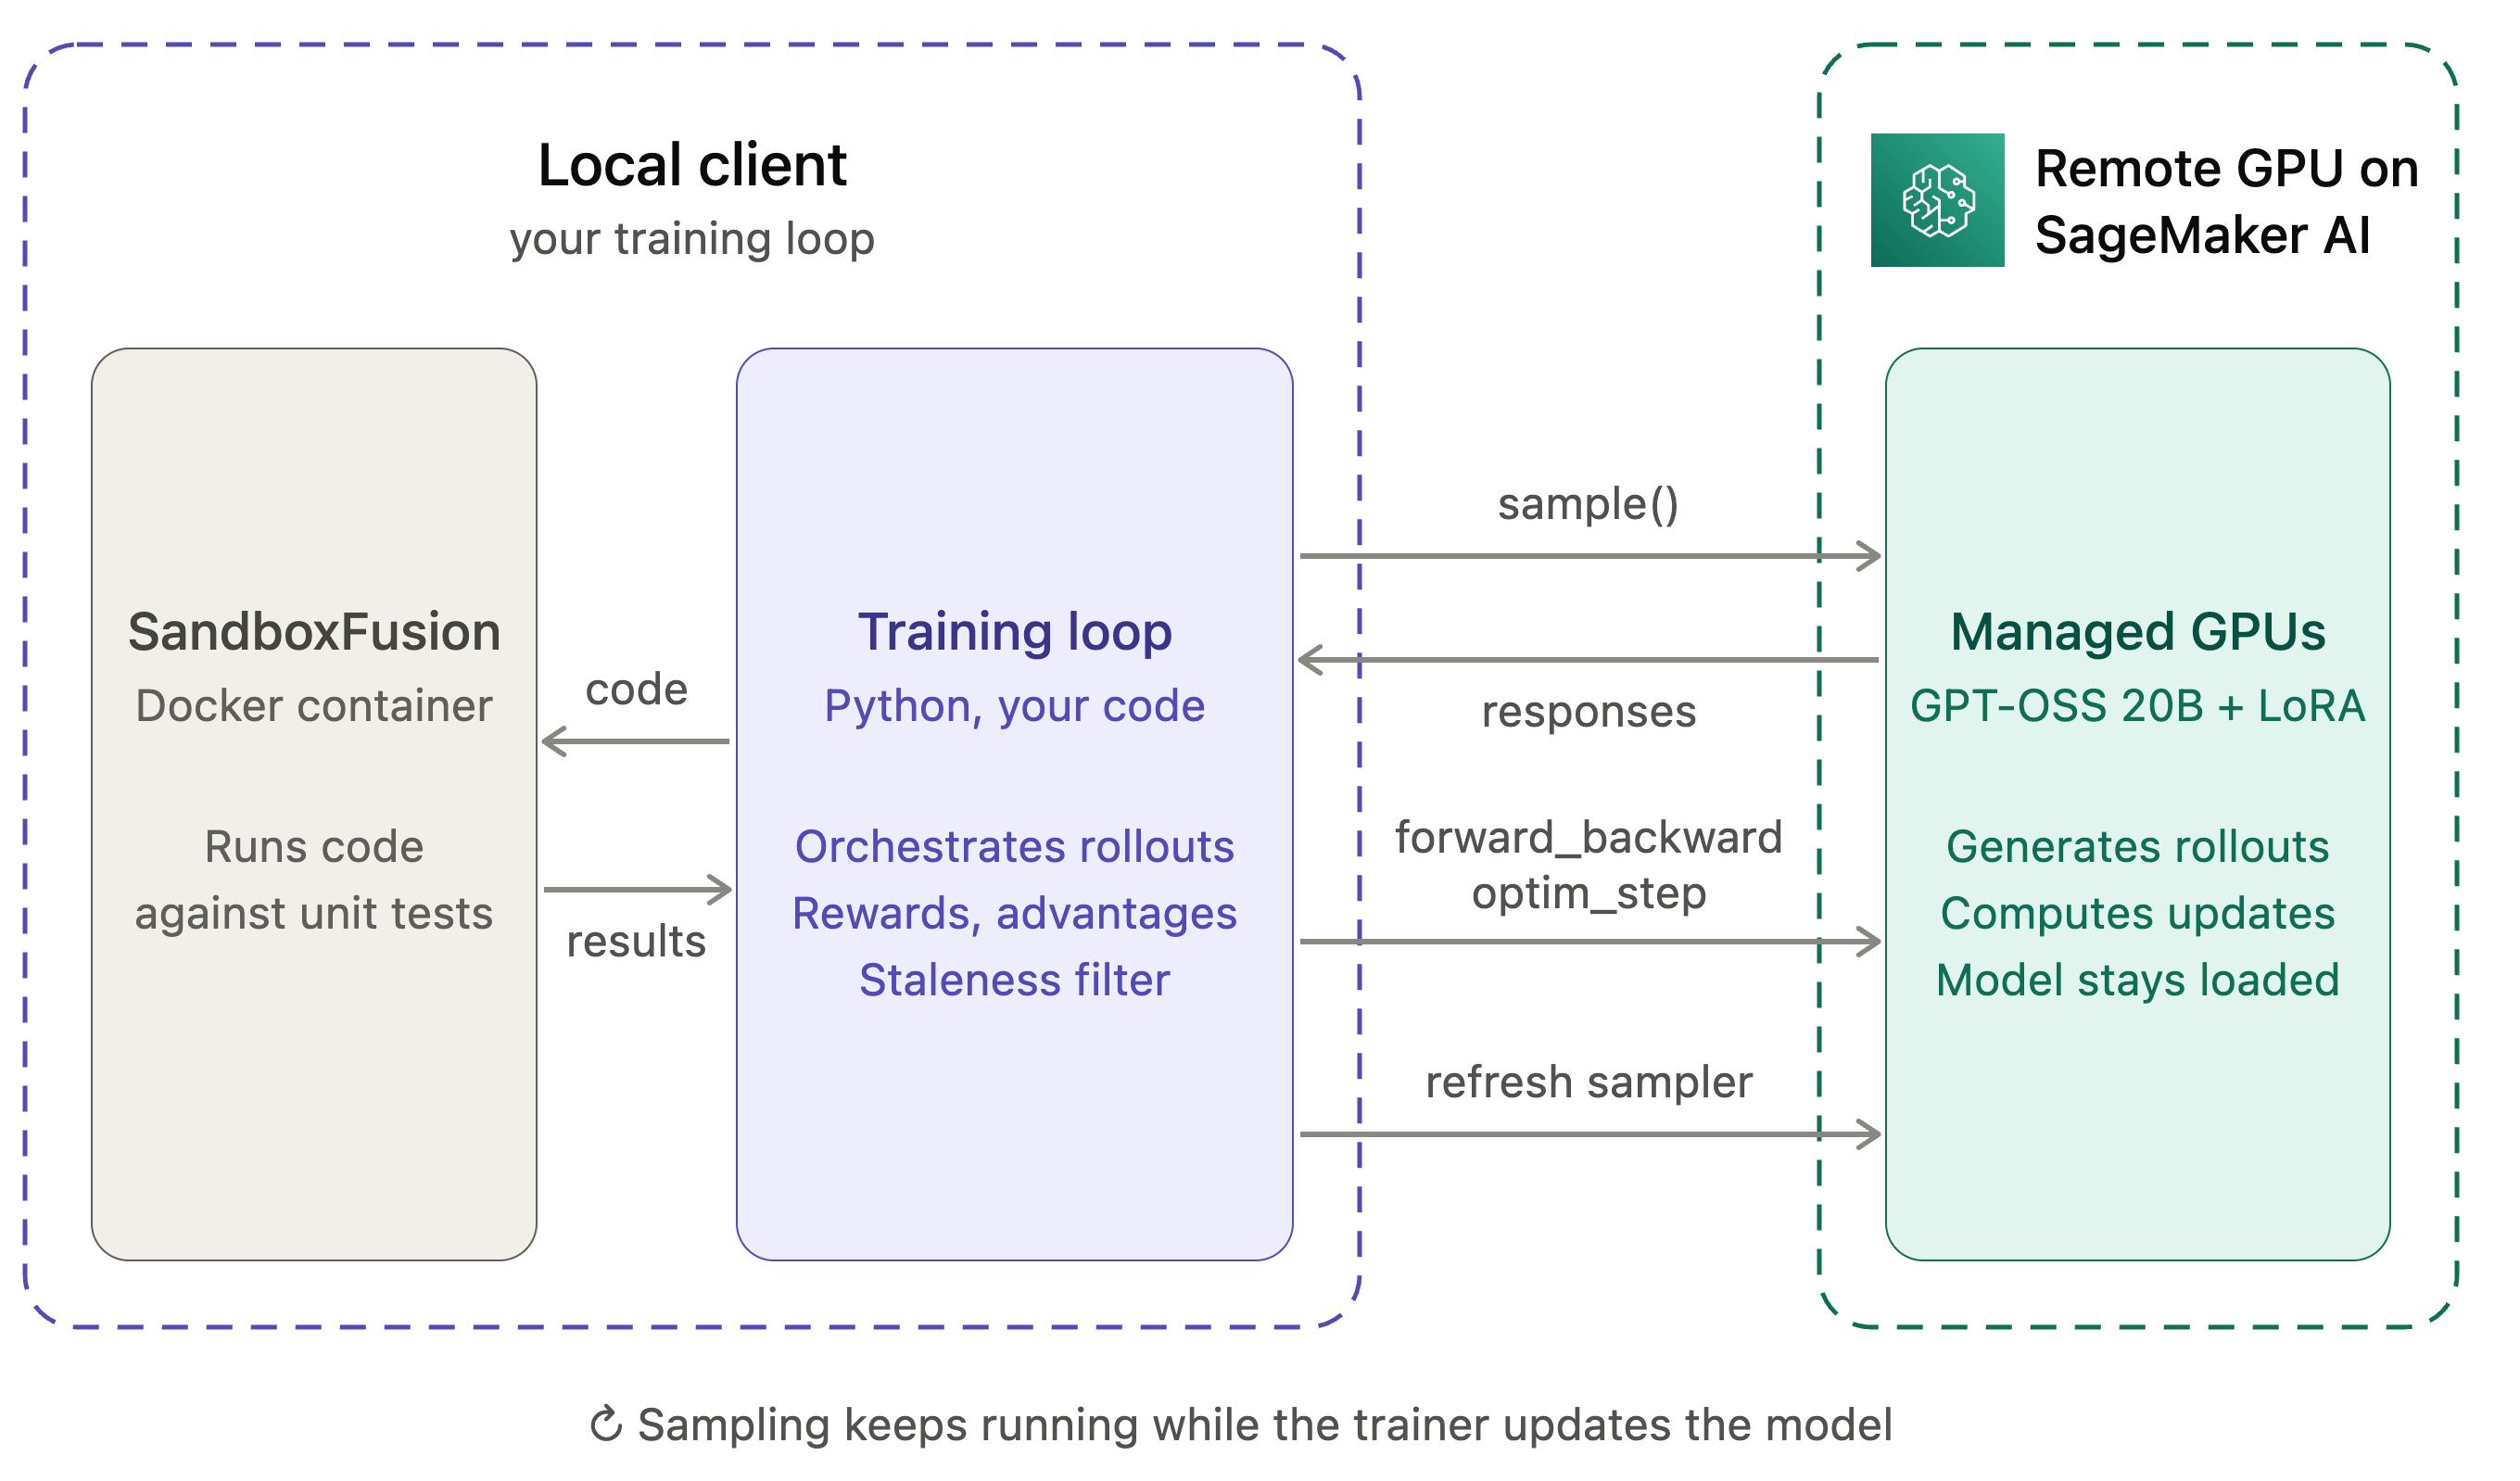
图 4:Code RL 设置,左侧为本地训练循环和沙箱,右侧为托管 GPU
我们使用两个轮次和 k=3 的陈旧度上限,为 GPT-OSS 20B 训练了一个 LoRA 适配器(秩为 32),共训练 50 步,每步包含 128 个问题,每个问题有 8 个响应。训练奖励从 0.46 提升到 0.60,在 200 个留出的测试问题上的准确率从 40 percent 提升到 50.5 percent。
要运行它,请启动沙箱并运行该配方:
bash tools/sandbox_up.sh
python -m training_sessions_cookbook.recipes.code_rl.train \
    --config training_sessions_cookbook/recipes/code_rl/configs/coderl_oss20b_service.json \
    --max_steps_off_policy 3 --stale_policy requeue --num_rollout_workers 80 --max_steps 50 \
    --base_model_arn "$BASE_MODEL_ARN" \
    --model_package_group_arn "$MODEL_PACKAGE_GROUP_ARN" \
    --role_arn "$ROLE_ARN" \
    --output_s3_path "$OUTPUT_S3_PATH"
该 Cookbook 还提供更多采用相同结构的配方,包括在聊天数据集(Tulu 3、UltraChat)上进行监督微调、在完整规模下使用 GSM8K 进行 RL,以及根据二元反馈进行 KTO 偏好对齐。每个配方的 README 都列出了其命令、超参数和预期指标。
结论
SageMaker AI 训练会话 API 将抽象边界下沉到训练操作:你在自己的机器上用 Python 编写训练循环,服务则在托管 GPU 上运行该循环,并负责模型和 LoRA 加载、分布式执行、故障恢复和检查点管理。一个完整的 GRPO 循环归结为四项操作:sample、forward_backward、optim_step 和 save_weights_and_get_sampling_client,奖励和优势逻辑则由你在自己的代码中实现。Code RL 配方展示了如何将同样的操作扩展到使用沙箱评分的多轮工具调用 RL。
自定义奖励、智能体式生成、逐步调试和新发布的技术都使用相同的编程模型:算法保留在你的循环中,而 SageMaker AI 负责运行 GPU。
开始使用:
- 从SageMaker 训练会话 Cookbook中选择一个配方,例如Code RL。
- 从 Amazon SageMaker 示例存储库运行GSM8K 示例,并替换为你自己的奖励函数。
- 阅读训练会话 API 文档,了解先决条件、配额、区域、支持的模型和 API 参考。
致谢
感谢 Arun Nagarajan、Xichao Wang 和 Shruti Sharma 为本文作出的贡献并提供指导。
关于作者

Nicolas Jourdan
Nicolas 是 AWS 的高级 AI/ML 专家解决方案架构师,常驻德国法兰克福。他为客户提供支持,帮助他们在 AWS 上构建 AI 和机器学习工作负载,涵盖从早期设计决策到投入生产的各个阶段。他的重点领域包括模型定制、分布式训练和推理。加入 AWS 之前,他曾担任研究科学家和工程经理,负责自动驾驶、无人机和制造业应用,并持有目标检测和异常检测方面的专利。

Bruno Pistone
Bruno 是 AWS 的高级全球生成式 AI/ML 专家解决方案架构师,常驻意大利米兰。他与 AWS 产品团队和大型客户合作,帮助他们充分了解自身的技术需求,并设计能够充分利用 AWS 云和 Amazon ML 技术栈的 AI 和机器学习解决方案。他的专长包括分布式训练和推理工作负载、模型定制、生成式 AI 和端到端机器学习。他喜欢与朋友共度时光、探索新地方以及前往新的目的地旅行。

Giuseppe Angelo Porcelli
Giuseppe 是 Amazon Web Services 的首席机器学习专家解决方案架构师。他拥有多年软件工程经验和机器学习背景,致力于与各种规模的客户合作,了解其业务和技术需求,并设计能够充分利用 AWS 云和 Amazon Machine Learning 技术栈的 AI 和机器学习解决方案。他参与过多个不同领域的项目,包括 MLOps、计算机视觉和 NLP,涉及广泛的 AWS 服务。闲暇时,Giuseppe 喜欢踢足球。

Pooja Karadgi
Pooja 是 AWS 的高级产品经理,负责 Amazon SageMaker AI 的模型定制。她专注于让基础模型更易于使用,并能切实应用于生产环境,帮助客户通过强化学习等技术使模型适应特定领域。她还参与了 SageMaker Studio 中面向开发者和管理员的体验设计,涵盖从实验到生产的整个机器学习生命周期。
来源:AWS Machine Learning Blog · aws.amazon.com