AWS 教程:在 Amazon SageMaker AI 上用 Kokoro TTS 为 AI 智能体流式生成低延迟语音
Stream low-latency speech from AI agents using Kokoro TTS on Amazon SageMaker AI
AWS 介绍了如何将 Kokoro-82M 部署到 Amazon SageMaker AI 双向流式端点,并在 AI 智能体生成每个句子后立即开始语音合成。测试显示,逐句发送使首个音频字节的平均时间从 329.3 ms 降至 156.7 ms;端到端测试中,双向流模式比批处理模式快 2.4 至 3.5 倍。
文章拆解了语音智能体从逐句生成到音频回传的实现路径,并比较 SSE 与双向流传输的开销和适用场景。
客户向 AI 语音代理提问并等待。代理已经有了答案,正在生成一段很长、分为多段的回复,但客户却有五秒钟什么也听不到。等答案传来时,客户已经感到沮丧和困惑,也不再专心听了。
文本转语音集成正是造成这种延迟的原因。一句话的回复可能在 600 毫秒内生成,但完整回复需要五秒,而集成会等到全部内容生成完毕后才开始合成。
本文将介绍如何消除这一延迟。代理每生成一句话,我们就立即将其流式传输到托管在 Amazon SageMaker AI 上的 Kokoro-82M 文本转语音(TTS)模型,因此从第一句话开始合成,无需等到整段回复完成。将音频传回浏览器也需要专门的解决方案,因此我们还将介绍两种传输方式,以及它们在实际使用中的成本。
解决方案概述
该解决方案通过在生成的同时进行流式合成,而不是等到生成完成,从而消除延迟。代理每生成一句话,就立即将该句流式传输到托管的 Kokoro-82M 文本转语音模型,因此即使代理尚未说完整段回复,也能开始播放音频。Kokoro-82M 仅有 82 million 个参数,小到可以在单个中端 GPU 实例上以低成本运行。这使语音代理在处理实际流量时,延迟和推理成本都能保持较低水平。
Kokoro-82M 在 SageMaker AI 实时端点上的自定义容器中运行,使用 ml.g5.xlarge GPU 实例。容器提供两个路由:POST /invocations,用于流式传输单条完整输入的响应;以及 WS /invocations-bidirectional-stream,用于在多条双向消息之间保持同一个连接打开。
下图展示了从客户端到模型的请求路径:
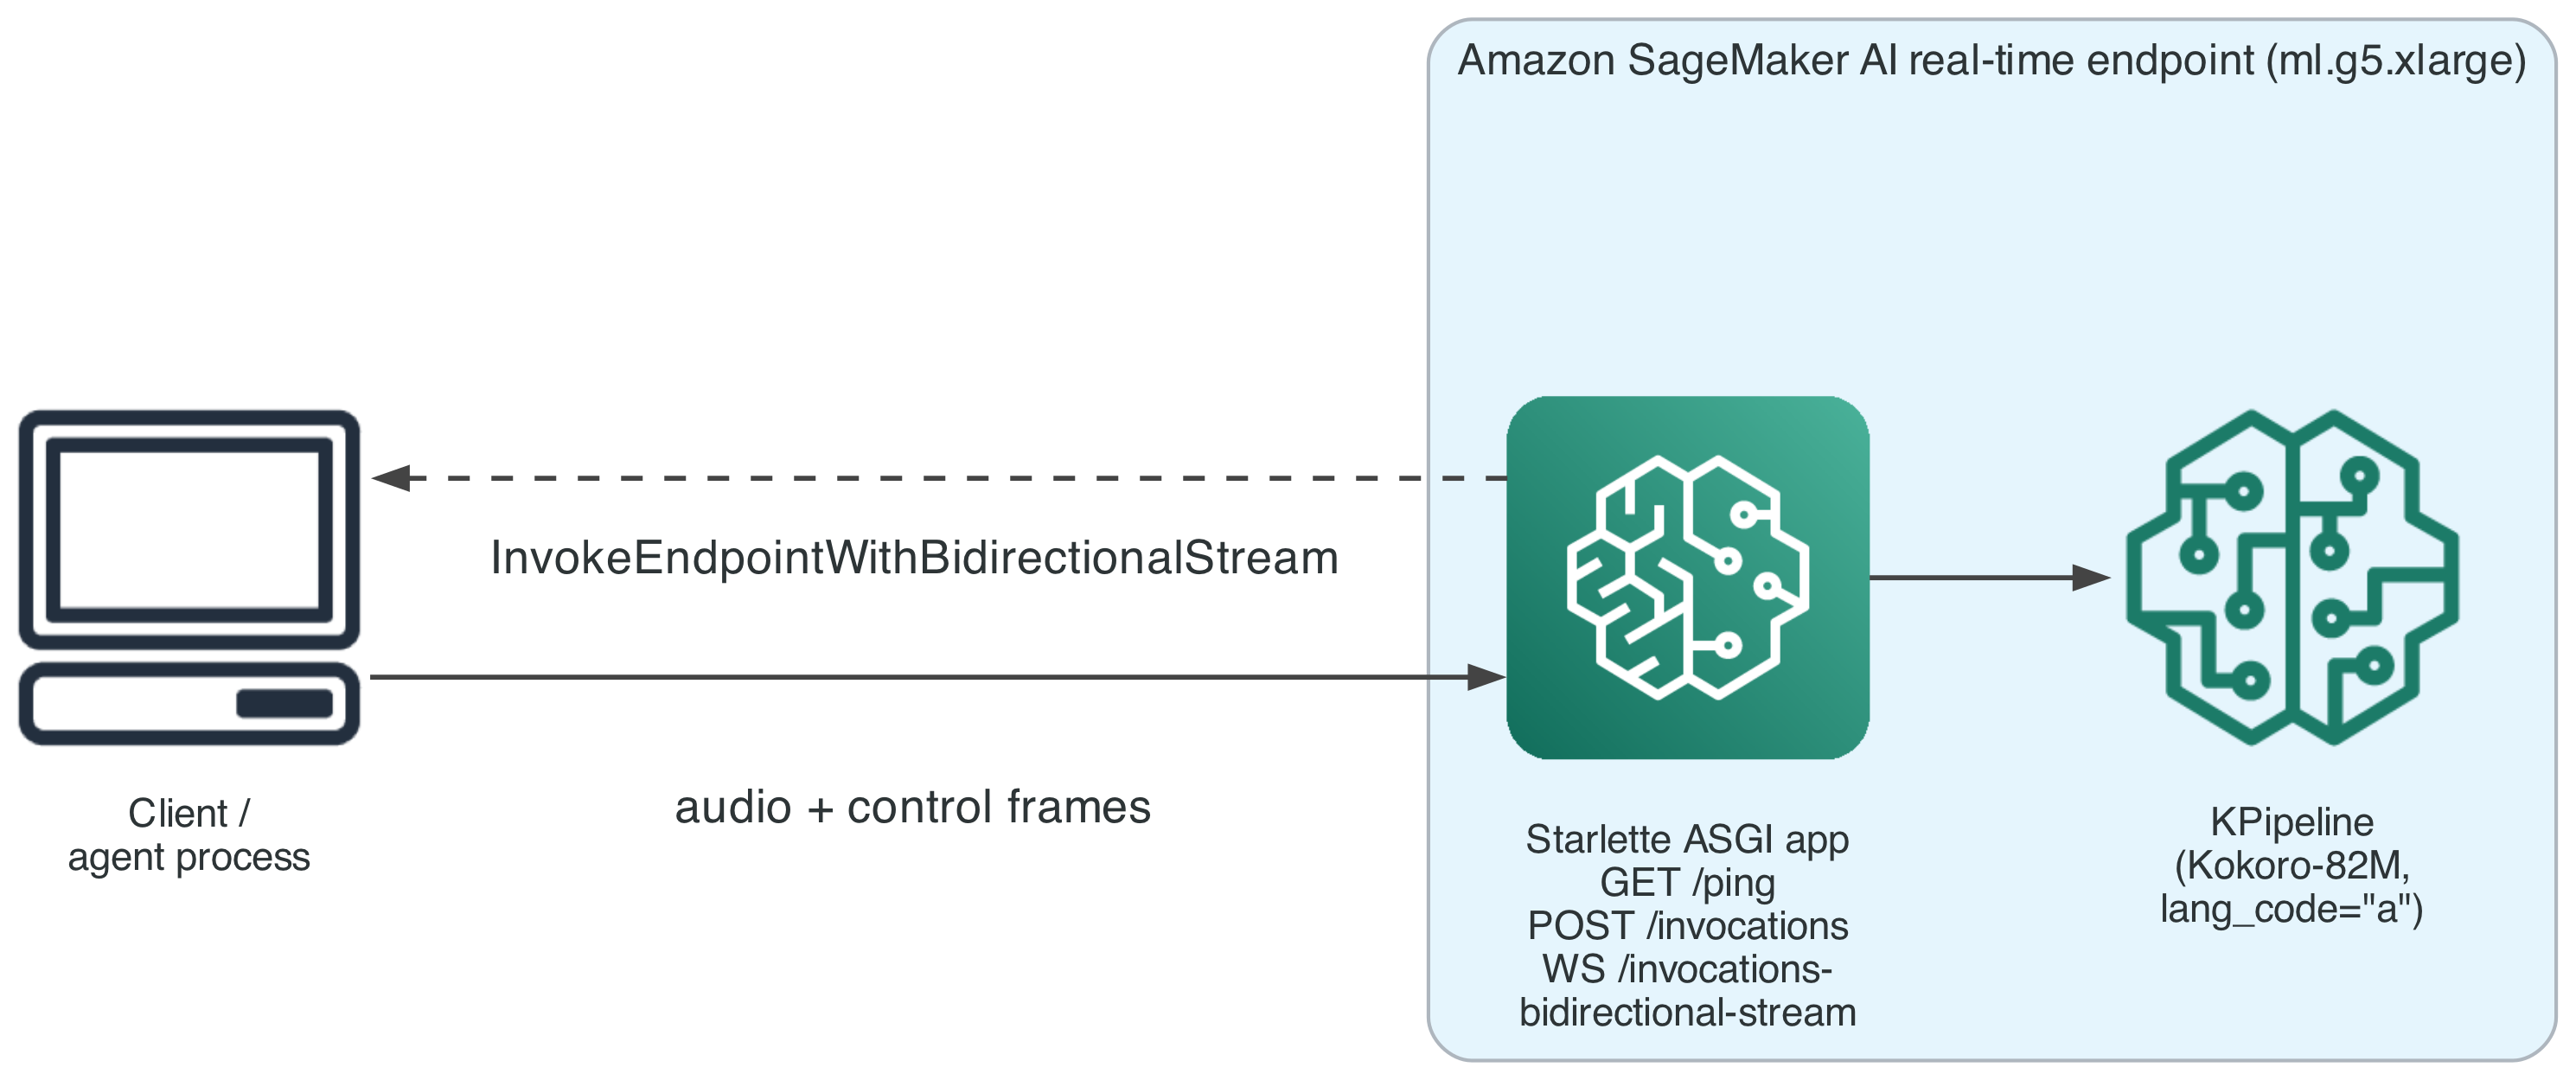
图 1:客户端通过双向流向 SageMaker AI 实时端点发送请求的路径
先决条件
开始之前,你需要具备:
- 一个拥有创建 SageMaker AI 端点所需权限的 AWS 账户;AgentCore runtime(Amazon Bedrock AgentCore 的一项功能);AWS Identity and Access Management (IAM) 角色;以及 Amazon Elastic Container Registry (Amazon ECR) 存储库,其中至少包含
sagemaker:CreateEndpoint、sagemaker:CreateEndpointConfig、sagemaker:CreateModel、sagemaker:InvokeEndpointWithBidirectionalStream和bedrock:InvokeModelWithResponseStream操作。 - 示例容器固定使用较旧版本的 PyTorch,该版本存在已知安全公告(
PYSEC-2026-2286,已在 torch 2.10.0 中修复)。在进行任何非概念验证用途之前,请检查并升级该固定版本。 - AWS Cloud Development Kit (AWS CDK) v2,已在目标账户和 AWS 区域中安装并完成引导设置。
- 从声明了
com.amazonaws.sagemaker.capabilities.bidirectional-streaming=trueDocker 标签的容器部署的 SageMaker AI 实时端点。 - Python 3.12 或更高版本、uv 和 Docker,用于构建容器映像(底层 HTTP/2 客户端仅为 Python 3.12 及更高版本提供预构建 wheel)。
- 支持
invoke_endpoint_with_bidirectional_stream的 AWS SDK for Python (Boto3)。 - 熟悉 WebSockets 和 Starlette 或类似的 ASGI 框架。
- 本文引用的 GitHub 存储库中的部署代码。
操作指南
本操作指南首先部署端点和代理,然后介绍客户端所需的更改,以实现端到端的增量流式传输。
部署端点和代理
Kokoro-82M 端点和代理运行时通过两个 CLI 工具部署,每个工具都封装了自己的 AWS CDK 堆栈:
uv run speech-infra deploy kokoro-82m
uv run agent-infra deploy --bedrock-model-id <your-bedrock-model-id>
speech-infra deploy 部署 Kokoro-82M 端点。这包括基础设施和模型缓存堆栈,用于创建底层 IAM 角色,并将模型权重同步到 Amazon Simple Storage Service (Amazon S3)。随后,端点堆栈会构建容器映像,并创建 SageMaker AI 模型、端点配置和端点。agent-infra deploy 部署托管 Strands 智能体的 Amazon Bedrock AgentCore 运行时。该智能体会调用刚刚部署的端点,因此请先部署端点。
步骤 1:处理 SageMaker AI 实际发送的 WebSocket 帧类型
SageMaker AI 使用的双向传输会将客户端消息的每个部分都作为二进制 WebSocket 帧传递给容器。编写 Starlette WebSocket 处理程序时,常见做法是调用 receive_text(),该方法会读取 message["text"],如果该键不存在,则会引发 KeyError。由于此客户端发送的每条消息都是以二进制形式到达的,该处理程序会在每个请求上失败。
这种故障常常被误诊。通用异常处理程序会将 str(e) 转发给客户端,从而把 KeyError('text') 转换成内容为 'text' 的错误帧,看起来像是缺少字段,而不是帧格式问题。端点始终报告 InService,因为它会接受连接并响应每条消息,只是每次响应都是错误。
应明确接受任一种帧类型,而不是假定只会出现其中一种:
from starlette.websockets import WebSocket, WebSocketDisconnect

async def _receive_message(websocket: WebSocket) -> str:
    message = await websocket.receive()
    if message["type"] == "websocket.disconnect":
        raise WebSocketDisconnect(message.get("code", 1000))
    payload = message.get("text")
    if payload is None:
        payload = message.get("bytes", b"").decode("utf-8")
    return payload
如果不存在文本字段,这段代码会将字节解码为 UTF-8,而不是假定只会出现一种帧类型。发送一个二进制帧来测试,因为这种故障模式会产生格式正确的错误帧和正常的端点状态,而不是明显的崩溃。
步骤 2:在消息之间保持会话开启
容器完成一条消息的音频合成后,你可能会想关闭会话,就像 HTTP 请求周期结束时那样。但这里不应该这么做。发送完一条消息的音频和一个 synthesis_complete 控制帧后,容器循环应继续等待,通过 receive() 在同一个仍然开启的会话上接收下一条消息。只有在客户端发送明确的 {"type": "close"} 消息时,才关闭连接。
下图展示了一个会话依次传输两个句子,仅在最后关闭:
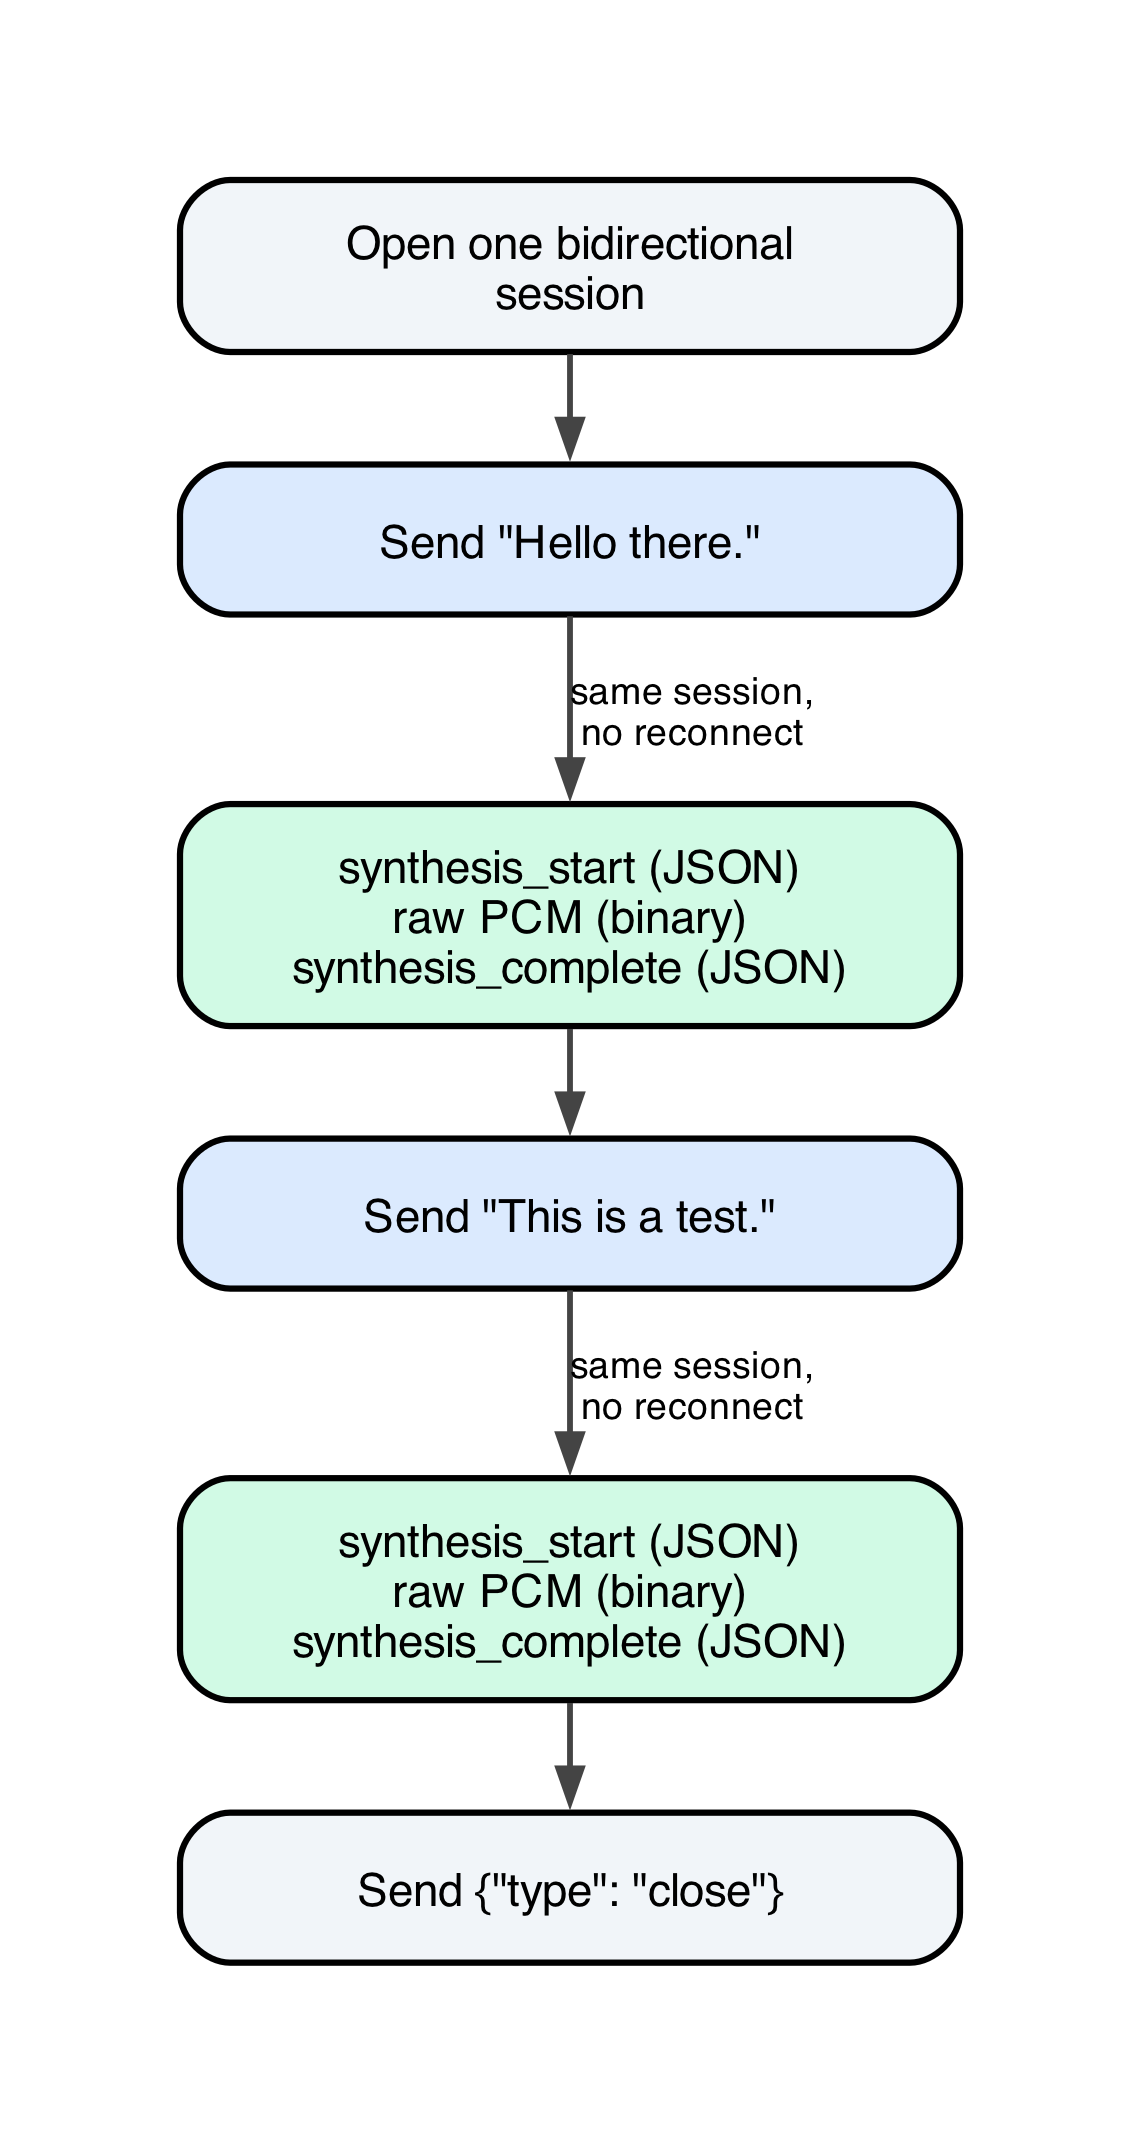
图 2:一个双向会话依次传输两个句子,仅在最后关闭
这样,你就可以在同一个持久会话中依次发送多个句子,无需在句子之间付出重新连接的成本。如果在一次响应后就立即关闭连接,每个句子都必须建立新连接,从而抵消大部分延迟优势。
步骤 3:在智能体生成句子时进行流式传输
会话处理方式就位后,解决延迟问题的客户端方案是使用一个类,对两种形式的输入文本进行规范化:预先已知的完整字符串,或实时令牌流。无论哪种形式,它都会生成相同的输出:完整句子,可在每个句子完成后立即发送。
import re

_SENTENCE_RE = re.compile(r"(?<=[.!?])\s+")


class IncrementalSentenceChunker:
    def __init__(self) -> None:
        self._buffer = ""

    def feed(self, fragment: str) -> list[str]:
        self._buffer += fragment
        parts = _SENTENCE_RE.split(self._buffer)
        if len(parts) == 1:
            return []
        self._buffer = parts[-1]
        return [s.strip() for s in parts[:-1] if s.strip()]

    def flush(self) -> str | None:
        remainder = self._buffer.strip()
        self._buffer = ""
        return remainder or None
每当收到一段文本时,就调用一次 feed()。它会返回新完成的句子,并暂存尾部文本。在输入结束时调用一次 flush(),释放剩余的部分文本,即使其末尾没有标点也一样。这样可以避免流在句号到达之前结束时,丢失最后一个句子。
这并不是并发合成。每个双向处理程序都是严格按顺序运行的循环:接收一条消息,合成其音频,发送该音频,发送 synthesis_complete,然后接收下一条消息。第二句的音频不会在第一句仍在传输时生成。增量发送带来的好处更有限:第一句一旦生成,就立即开始合成,而不是等到完整响应生成后才开始。对于一段多句响应,如果第一句和最后一句之间确实需要时间来生成内容,这就是全部的延迟收益。
我们通过一个实时端点验证了这一点:在同一会话中发送包含三句话的输入。收到的三个分块都包含音频,且音频与各自发送的文本相符:
| 分块 | 文本 | 音频字节数 | 时长(秒) |
| 1 | “你好。” | 73,200 | 1.525 |
| 2 | “这是一次部署后的检查。” | 108,000 | 2.250 |
| 3 | “它有三句话。” | 98,400 | 2.050 |
第 4 步:选择一种将音频传回客户端的传输方式
将文本逐步输入模型,只解决了问题的一半。另一半是将生成的音频传输到负责渲染它的设备,通常是浏览器。大多数智能体和聊天前端已经通过服务器发送事件(SSE)流式传输文本:这种方式是单向的,而且大多数浏览器都原生支持。SSE 是一种文本协议,并非为承载原始二进制负载而设计。为现有 SSE 流程添加语音功能的团队,自然会选择已有的模式:将音频进行 base64 编码,再封装进 JSON 事件中。
我们对 24 段音频采用这种方式的开销进行了测量,通过 Amazon Transcribe 确认不同编码的音质没有差异,并比较了 MP3 和 AAC:
| 候选格式 | 原始字节数 | Base64 字节数 | 比特率 |
| 原始 PCM | 2,396,400 | 3,195,200 | 384 kbps |
| MP3 48k | 308,304 | 411,072 | 49.5 kbps |
| AAC 32k fMP4 | 258,039 | 344,084 | 41.6 kbps |
Base64 会使每个负载膨胀近乎预期的 33%。更隐蔽的代价是帧对齐。SSE 事件以空行分隔,而其中的音频则按 MP3 帧分隔。这两种分隔方式与传输层对数据进行分块的方式不一定对齐。在一次测量的响应中,4 个逻辑 MP3 帧分成了 6 个传输块,其中两个在帧中途结束。如果消费者将每个传输块都视为一个完整单元,那么在普通、正常的流量下也会失败。解决方法是缓冲接收到的字节,并且只在找到分隔符后才处理:
buffer = b""
for event in resp["Body"]:
    if "PayloadPart" not in event:
        continue
    buffer += event["PayloadPart"]["Bytes"]
    while b"\n\n" in buffer:
        frame, buffer = buffer.split(b"\n\n", 1)
        handle(frame)
目前用于面向模型的一端的替代方案完全跳过了 base64 和 SSE 分帧。它通过同一个双向会话复用原始二进制音频和 JSON 控制帧;该会话也已用于传输增量输入文本,并用一条规则区分两者。
import json


def _decode_control_frame(chunk: bytes) -> dict | None:
    try:
        decoded = json.loads(chunk.decode("utf-8"))
    except (UnicodeDecodeError, json.JSONDecodeError):
        return None
    return decoded if isinstance(decoded, dict) else None
无法解码为 JSON 对象的分块就是音频,会按接收时的样子直接转发,整个路径中不进行任何编码。需要注意一个边缘情况:原始 PCM 音频的开头可能合法地是字节 0x7b,即 ASCII 字符 {,也就是用于开启 JSON 对象的同一个字符。这条规则可以避免将该音频误分类,因为它要求整个分块都能解析为有效 JSON,而非只检查首字节;PCM 帧几乎不可能满足这一条件。
注意:如果你的前端已经有可正常工作的文本 SSE 流程,那么在 SSE 事件中携带 base64 编码音频是务实的选择。它会使负载增加约 33%,并需要缓冲和重组,但能复用你已经在运行的基础设施。如果你正在从头构建语音链路,或者延迟是首要考虑因素,那么统一的二进制和 JSON 方案可以避免这两项开销,并复用已经承载文本的连接。
第 5 步:在实际智能体中整合这些内容
更完整的端到端场景是:一个实时生成式代理逐个 token 地生成响应,在第一句生成之前,它无法知道第四句的内容。本示例运行在 Strands agent 上,由 Amazon Bedrock 提供支持,部署到 Amazon Bedrock AgentCore runtime,并按照第 4 步中的模式调用 Kokoro endpoint。在这一设计中有三条通信链路:面向浏览器、将 Server-Sent Events 返回给调用方的链路;代理向 Amazon Bedrock 发起文本生成流式调用的链路;以及代理与 Kokoro endpoint 之间用于合成的双向会话。
下图展示了这三条通信链路,以及生成与合成之间发生重叠的位置:
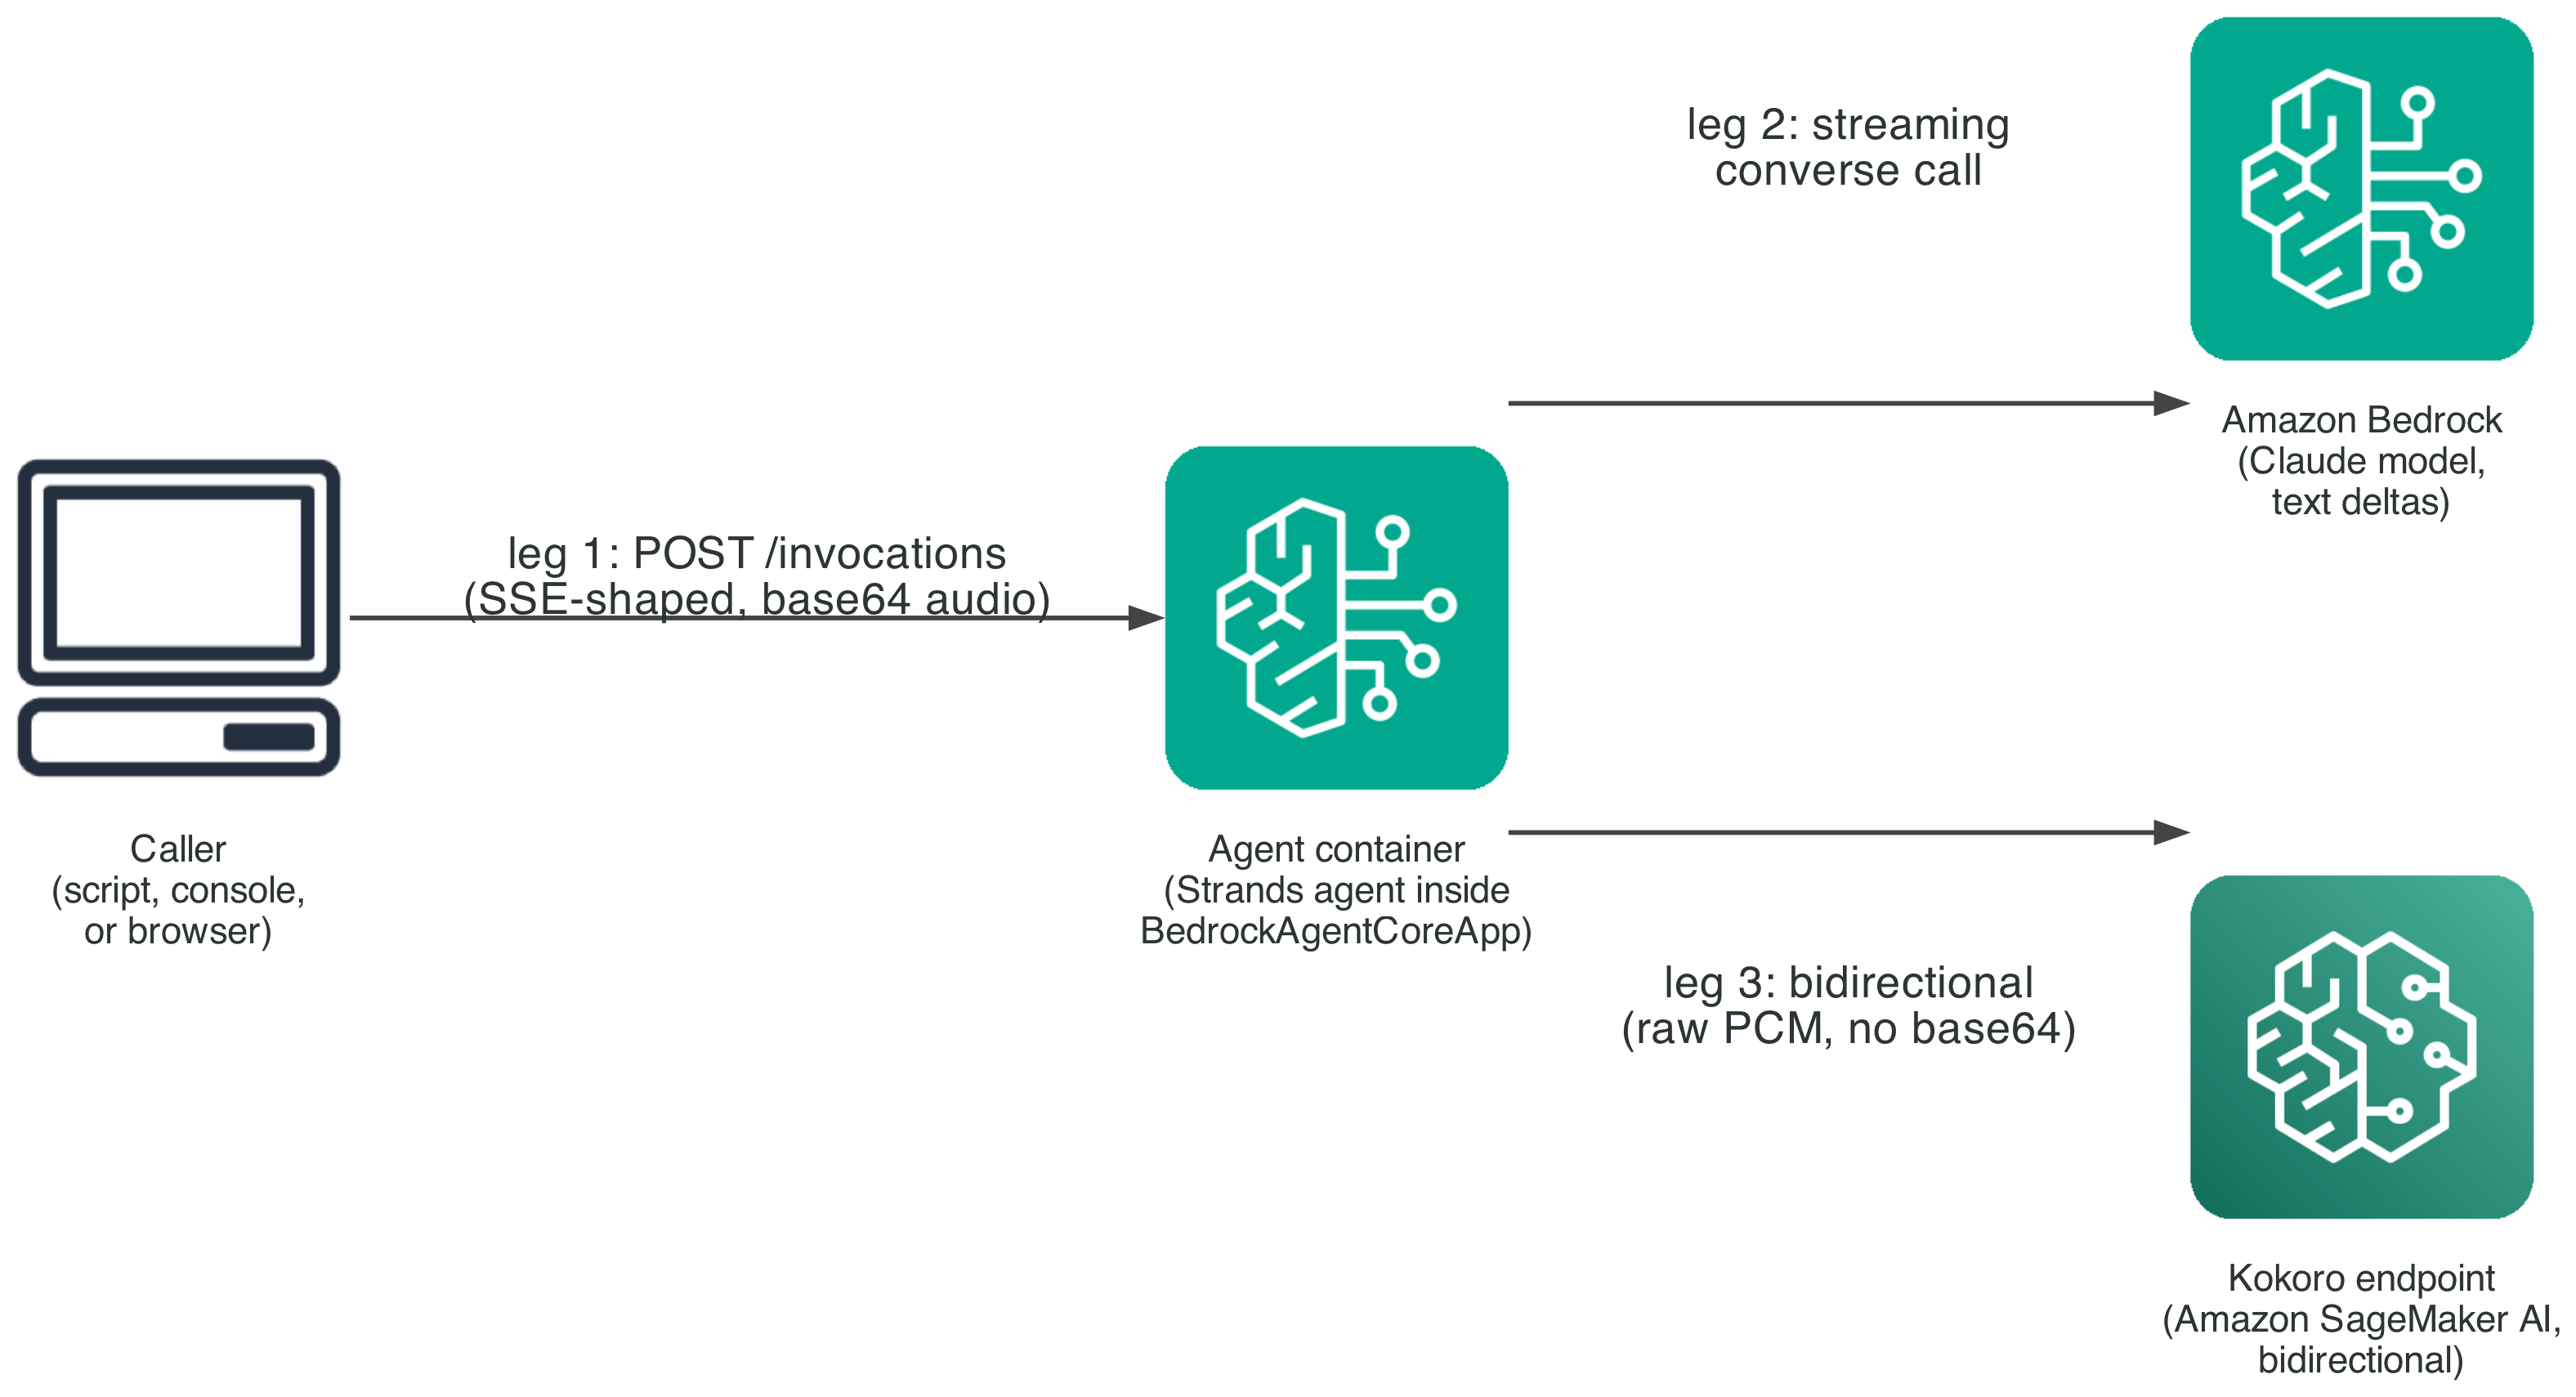
图 3:连接调用方、Amazon Bedrock 和 Kokoro endpoint 的三条通信链路
请求负载包含一个 mode 字段,其值可以是 "bidi" 或 "batch",并被分派到同一入口函数内部的两条代码路径。对两者进行基准测试时,唯一改变的变量是合成开始的时机。在 run_bidi 中,两个任务并发运行。其中一个任务持续读取 Bedrock 文本流,并将已完成的句子传入分块器;另一个任务持续读取 Kokoro 会话,并在音频块到达时发出它们。两者都写入同一个共享队列,因此消费者会按照事件实际到达的顺序生成事件:较早句子的音频可以在 Bedrock 仍在生成后续句子时抵达调用方。run_batch 则是有意设置的相反方案:等待完整响应生成完毕后再进行一次合成调用,作为公平的基线。
反过来看,从代理容器返回调用方的链路确实使用了 base64,但原因与第 4 步所描述的不同。BedrockAgentCoreApp 的入口函数必须生成普通的、可序列化为 JSON 的字典,其 SDK 会自动将这些字典转换为 data: {json}\n\n 帧。无法向它直接传递原始二进制帧。这是 JSON 原生托管运行时所带来的结果,而不是第 4 步所测量并随后弃用的方案。在这条链路上,run_bidi 和 run_batch 承担完全相同的成本,因此两者之间测得的差异纯粹来自时序:第一个音频块何时发出。
测试与验证
我们通过以下方式隔离 TTS 传输本身对首个音频到达时间的影响:将同一段包含 267 个字符、四句话的文本分两种方式发送:作为一条消息发送(批处理),以及仅发送其中的第一句话(增量)。我们针对线上 endpoint 分别进行了五次测试。
如前文所测,仅发送第一句话将首个音频字节的平均到达时间从 329.3 ms 降至 156.7 ms,相对提升 52.4%,这一提升完全来自 TTS 传输本身。
随后,我们使用真实语言模型生成文本,测量了更完整的端到端场景:针对同一个线上 Bedrock 模型和 endpoint,将完全相同的提示分别通过 run_bidi 和 run_batch 运行,因此唯一变量就是合成开始的时机。
采用相同的方法,相对于批处理模式,bidi 模式在本地容器中的首个音频到达时间快了 2.4 倍,在部署的 AgentCore runtime 中则快了 3.5 倍。
下图展示了两种环境中的这一差距:
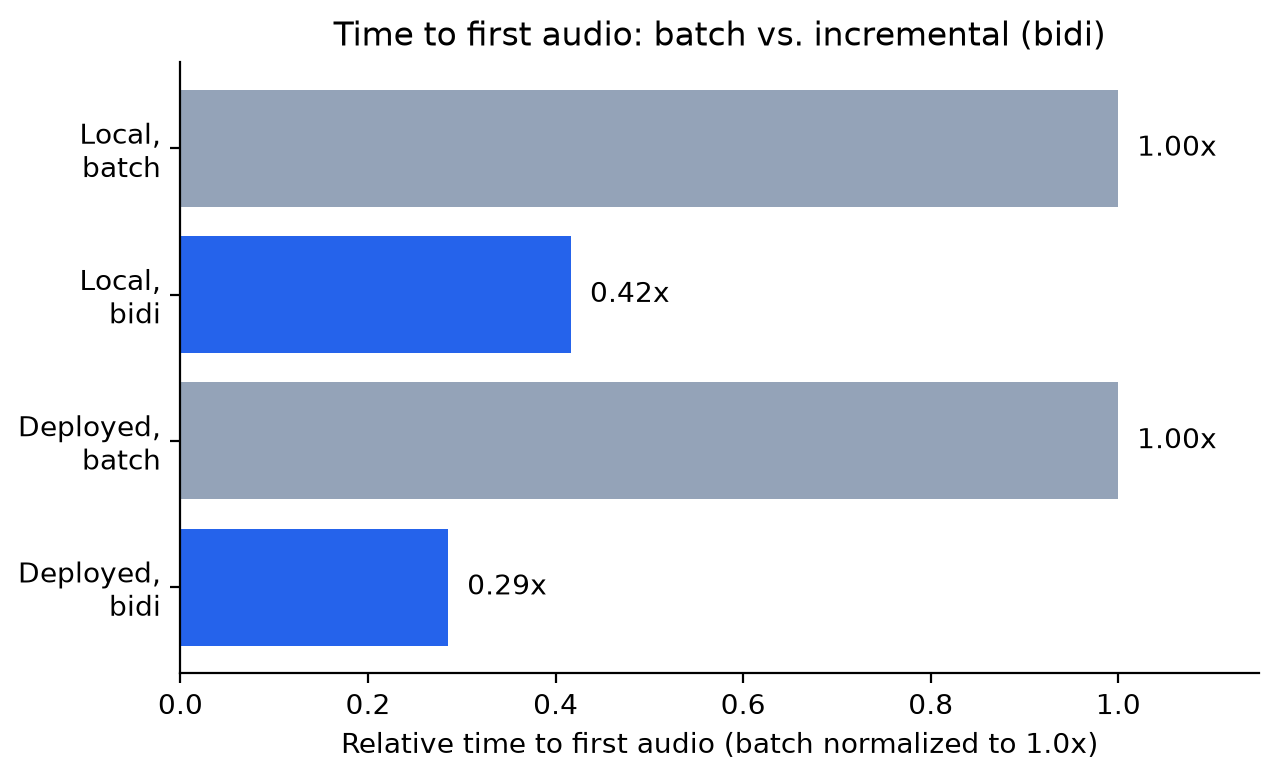
图 4:批处理模式和 bidi 模式在本地及部署运行时中的相对首个音频到达时间
在部署场景中加入真实网络跳转后,这一差距反而扩大,而不是缩小。run_bidi 将这次跳转隐藏在其已经利用的生成与合成重叠过程中。run_batch 没有等效的重叠机制来隐藏这一成本,因为它一次只执行一项操作,因此网络开销每增加一毫秒,都会直接落到其串行等待时间上。
要在您自己的部署中复现此比较,请运行 Agent 容器提供的相同 bidi-vs-batch 测试:
uv run agent-infra demo --endpoint-url <your-endpoint-url> --prompt "<your prompt>"该测试会在两种模式下发送提示,并分别报告首次 audio_chunk 事件相对于 agent_start 的时间戳。如果看到的是错误,请检查步骤 1 中的 KeyError: 'text' 症状。如果某个端点报告 InService,但每个请求都失败,则表明存在该错误,而不是部署问题。
清理
为避免持续产生费用,请按部署顺序的反向顺序拆除此演练创建的资源:先拆除 Agent,再拆除端点:
uv run agent-infra destroy --bedrock-model-id <your-bedrock-model-id>
uv run speech-infra destroy kokoro-82m
agent-infra destroy 会移除 Amazon Bedrock AgentCore 运行时资源。speech-infra destroy 会移除 SageMaker AI 模型、端点配置和端点。这两项操作都不会清空用于缓存模型权重的 Amazon S3 存储桶,也不会删除存放容器映像的 Amazon ECR 存储库,因为这两者可能由多个模型共享。如果不再需要它们,请手动清空并删除 Amazon S3 存储桶,并移除 Amazon ECR 存储库,因为存储的模型检查点和容器映像在删除之前会持续产生少量存储费用。
结论
我们展示了如何消除语音 Agent 中一种可避免的延迟来源:等待 Agent 完整响应后才开始语音合成;还展示了如何量化另一种不易察觉的成本:SSE 中经过 base64 编码的音频会使负载膨胀约三分之一,而且如果不进行缓冲处理,还可能与 MP3 帧边界错位。Agent 每生成一句话,就立即将其流式传输到 SageMaker AI 双向端点,这种做法单独使用时将首次音频时间缩短了一半以上;在已部署的 Agent 中则缩短了 2.4 至 3.5 倍。在该会话中多路复用二进制音频和 JSON 控制帧,而不是将音频编码为文本,可以消除负载膨胀以及朴素 SSE 中继所需的帧重新对齐工作。
如果您要为已经通过 SSE 流式传输文本的 Agent 添加语音功能,请先采用步骤 4 中的 base64 方法;等延迟成为优先事项后,再考虑使用统一传输方式。要了解更多信息,请参阅Amazon SageMaker AI 实时推理文档和Amazon Bedrock AgentCore 文档。如果您希望获得帮助,将此模式应用于自己的架构,请联系您的 AWS 客户团队。
关于作者

Joseph Cottingham
Joseph 是 AWS Generative AI Innovation Center 的机器学习工程师,负责设计并交付 AI 系统,帮助组织将创意转化为生产应用。他的技术背景涵盖固件、软件和机器学习,并在能够确保 AI 工作负载大规模高效运行的高吞吐量事件驱动架构方面拥有深厚专长。Joseph 专注于前沿研究与运营实际的交汇点,交付能够切实改变组织及其运营系统的解决方案。
来源:AWS Machine Learning Blog · aws.amazon.com