Reflection AI 发布面向智能体编码的开放权重模型 Beam,并介绍其在 AWS 上的部署方法
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
Reflection AI 发布开放权重模型 Beam,面向智能体编码和多步骤任务,并介绍通过 AWS 部署的方法。Beam 有 501 billion 总参数、23 billion 激活参数,Reflection 报告其有效上下文长度为 1 million tokens;Beam 1.0 提供 BF16、FP8 和 NVFP4 检查点。
文章把 Beam 的参数规模与部署路径放在一起说明,便于对照托管端点和自定义推理运行时的运维控制需求。
Reflection AI推出了 Beam,这是一款用于智能体编程和长期任务的开放权重模型,可执行代码维护、工具调用、结果解读以及多步骤工作流完成等任务。开放权重版本让开发者和研究人员能够控制运行时、部署环境和定制流程。
在本文中,我们将介绍 Reflection 的愿景,并展示如何在 AWS 上部署 Beam。首先,可以使用 Amazon SageMaker JumpStart 实时端点,采用完全托管的部署方式。当需要对分布式 GPU 基础设施进行 Kubernetes 原生控制时,可结合 JumpStart、SGLang 或 vLLM 使用 Amazon SageMaker HyperPod Inference。我们还将说明 Beam 的 501 billion 总参数如何影响检查点存储、权重内存、分片和并行,而其 23 billion 激活参数又如何影响每个 token 的计算量。
发布时,Beam 已在 US East (N. Virginia) 和 US East (Ohio) 区域的 Amazon SageMaker JumpStart 中提供。
Reflection 对开放智能的愿景
Reflection 的使命是通过开放模型权重、公开研究成果和开源软件,让智能开放并惠及所有人。其完整 AI 技术栈涵盖模型、核心软件、生产基础设施和应用程序。Beam 将这一理念带给构建软件工程和智能体系统的开发者。
关于 Reflection Beam
Beam 是一种稀疏混合专家模型,用于解决软件问题、修改代码、调用工具并根据中间结果采取行动。它拥有 501 billion 个总参数和 23 billion 个激活参数,Reflection 表示其有效上下文长度为 1 million tokens。
Reflection 通过 Hugging Face 在 Apache 2.0 许可证下发布 Beam 的权重。Beam 1.0 提供 BF16、FP8 和 NVFP4 检查点变体。这些格式具有不同的内存占用和硬件兼容性。你可以使用 AWS 托管的 JumpStart 容器配置部署该模型,也可以在 AWS 环境中使用 SGLang 或 vLLM 检查并定制模型。
了解部署架构
选择符合控制和扩展需求的服务路径。
- 当你希望使用 AWS 托管的模型包、端点和调用 API,而无需运行 Kubernetes 时,请从SageMaker JumpStart 实时端点开始。
- 当你希望在由 Amazon Elastic Kubernetes Service (Amazon EKS) 编排的 HyperPod 集群上使用 AWS 托管的容器和模型配置时,请使用HyperPod Inference 上的 JumpStart。
- 当你需要控制服务镜像、运行时参数、量化或分布式执行时,请使用HyperPod Inference 上的 SGLang 或 vLLM。
- 请根据检查点存储、权重内存、KV 缓存、上下文长度、批处理、运行时开销和受支持的并行方式,为部署确定规模。
- 确定预期的并发量和延迟目标,然后根据测得的工作负载行为配置副本、缓存、路由和自动扩缩容。
JumpStart 实时路径会将模型、容器和端点封装在托管部署工作流之后。HyperPod 路径则开放集群和服务运行时,使你能够控制分布式执行、缓存、路由和扩展。
下图展示了 HyperPod 路径所用的组件。Beam 可通过 SageMaker JumpStart、Hugging Face Hub 或可选的 Amazon Simple Storage Service (Amazon S3) 镜像获取。分布式工作器使用 AWS 托管的 JumpStart 容器,或自定义的 SGLang 或 vLLM 运行时。
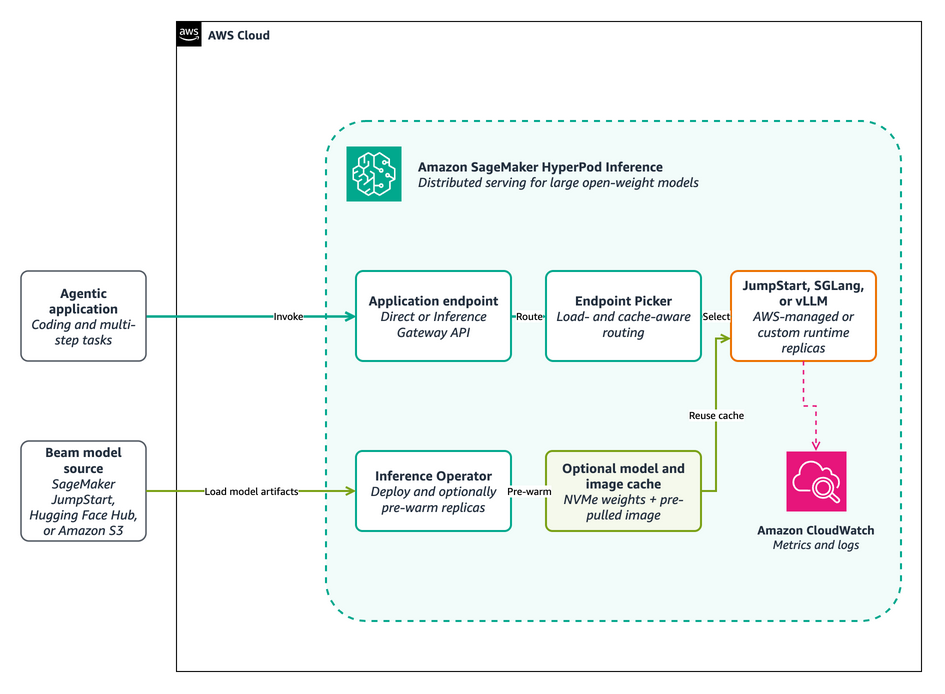
图 1:使用 Amazon SageMaker HyperPod Inference 的分布式 Beam 部署
前提条件
你需要:
- 一个 AWS 账户,并拥有所选 SageMaker 部署路径及其配套 AWS Identity and Access Management (IAM)、网络和存储资源所需的权限。
- 通过 SageMaker JumpStart 或 Hugging Face 上的某个 Beam 1.0 检查点存储库访问 Beam。
- 接受模型条款,并安装 AWS Command Line Interface (AWS CLI) 和 Python 3.11 或更高版本。
- 支持的 Beam 配置所需的 GPU 配额和容量。
规划并获取 GPU 容量
Beam 总计 501 billion 个参数,需要多 GPU 部署。BF16 对权重内存的需求最大,因此请规划多节点配置,确保 GPU 总内存足以容纳权重和运行时开销。对于 FP8,请使用 ml.p5.48xlarge 和 NVIDIA H100 GPU,或使用 ml.p5e.48xlarge 和 ml.p5en.48xlarge 及 H200 GPU。对于 NVFP4,请使用 ml.p6-b200.48xlarge 和 NVIDIA B200 GPU。请确认已发布的检查点、运行时和并行布局支持所选实例类型。
- 计算单个副本的权重、KV 缓存和运行时开销所需内存,然后通过负载测试确认估算结果。
- 选择支持所需加速型实例的 AWS 区域。
- 检查所选实例类型的服务配额和可用容量。容量允许时使用按需容量,或使用 SageMaker 训练计划为计划中的工作进行短期预留。
- 预留足够时间用于镜像传输、权重下载、分片加载和运行时初始化。
路径 1:开始使用 SageMaker JumpStart 实时端点
如果你希望以最短路径从模型目录部署到托管 HTTPS 端点,请首先使用 JumpStart 实时端点。此示例通过一条可识别变体的命令支持 BF16、FP8 和 NVFP4 模型 ID。其 README 和 Python 文件是有关支持的实例类型、请求架构、部署命令和清理命令的权威信息来源。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the SageMaker JumpStart deployment sample directory.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Create and activate a Python virtual environment.
python3 -m venv .venv source .venv/bin/activate - Install the sample dependency.
python -m pip install -r requirements.txt - Run the bounded deployment, invocation, and cleanup lifecycle for FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
该命令会部署 FP8 端点、发送一个简短请求、打印响应并清理端点。使用
bf16或nvfp4选择其他检查点变体;如果省略--variant,则默认使用 NVFP4。需要让端点持续运行时,请使用 README 中的 Python 函数。
路径 2:使用 SageMaker HyperPod Inference 部署
如果你需要对分布式 GPU 基础设施进行 Kubernetes 原生控制,请使用 HyperPod Inference。你可以使用 AWS 托管的 JumpStart 容器配置,也可以通过 SGLang 或 vLLM 部署 Beam。HyperPod Inference 部署示例 README及其配置文件是有关已发布清单、模型和镜像标识符、支持的运行时版本及命令的权威信息来源。
开始之前,请配置 kubectl,以便访问由 EKS 编排并安装了 HyperPod Inference Operator 和所需附加组件的 HyperPod 集群。你还需要集群虚拟私有云 (VPC)、子网、安全组、对所选 Beam 和运行时制品的访问权限,以及在启用模型缓存时所需的本地 NVMe 容量。如果所选存储库要求身份验证,请使用专用的 Hugging Face 访问令牌。
从 Hugging Face Hub 部署固定版本的 Beam,用于开发和实验。对于生产部署和模型缓存,请将检查点复制到 Amazon S3 或 Amazon FSx。HyperPod 模型和镜像缓存可以将权重预加载到节点本地 NVMe 存储,并预拉取服务镜像。
HyperPod Inference Gateway提供兼容 OpenAI 的接口,并在多个副本之间路由请求。HyperPod Inference 还支持托管式分层 KV 缓存和智能路由。这些功能是Amazon SageMaker Inference 于 2026 年推出的功能之一。
下图进一步展示了模型准备和运行时请求流程。启用模型缓存后,Inference Operator 会使用选定的权重和服务镜像预热符合条件的节点。在运行时,Inference Gateway 和 Endpoint Picker 可以将每个请求路由到合适的 JumpStart 托管、SGLang 或 vLLM 副本。
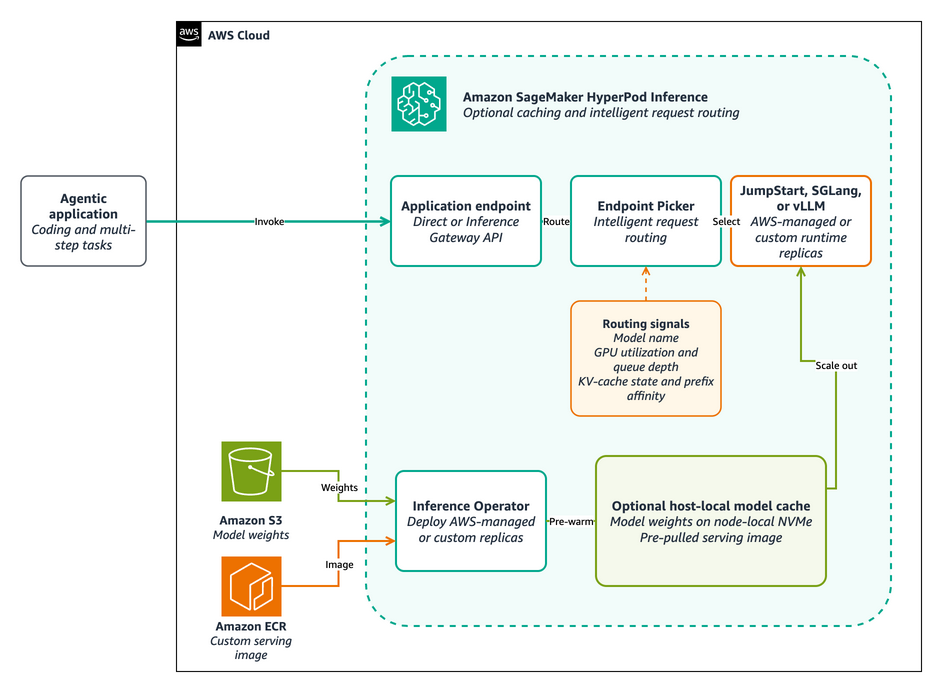
图 2:HyperPod 模型缓存和请求路由
准备部署构件
使用不可变的输入,以便复现部署和性能结果。
- 使用部署示例中记录的 JumpStart 模型版本。
- 为自定义运行时选择 BF16、FP8 或 NVFP4 检查点。
- 对于自定义运行时,请在示例发布配置中保留公开的 Beam 提交 SHA 和镜像摘要。
- 仅当集群无法拉取上游镜像,或组织要求使用经过批准的镜像仓库时,才将已发布的镜像镜像到私有 Amazon Elastic Container Registry (Amazon ECR) 仓库。
- 不要将令牌、生成的密钥、私有模型 ID、镜像仓库凭据和未发布的结果放入代码仓库。
选择服务路径
除非工作负载需要特定推理运行时或配置,否则请从 SageMaker JumpStart 开始。
| 服务路径 | 适用场景 | 需要管理的内容 |
| SageMaker JumpStart | 希望使用 AWS 托管的容器和模型配置,减少运行时维护工作。 | 选择 Beam 模型版本、支持的实例类型、端点配置和扩缩策略。 |
| SGLang 或 vLLM | 需要特定推理运行时或配置,例如自定义运行时参数、解析器、量化或并行化。 | 固定受支持的运行时镜像、模型版本、解析器配置和分布式执行设置。 |
使用 SageMaker JumpStart 部署
SageMaker JumpStart 减少了容器集成工作,同时 HyperPod 仍可控制集群容量、扩缩和可观测性。
- 在 SageMaker Studio 中,打开 JumpStart 模型目录。
- 在 所有公开模型 下,选择 Beam。
- 选择 SageMaker HyperPod 作为部署目标。
- 选择集群和 Kubernetes 命名空间。
- 输入端点名称,然后选择 部署。
- 使用已发布的 JumpStart 请求架构调用端点前,请确认部署状态。
对于基础设施即代码工作流,请使用 HyperPod 示例中已发布的 JumpStart 配置。配置部署前,可以查看reflection-beam-jumpstart.yaml 清单模板。
- Clone the sample repository, and enter the HyperPod Beam directory.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the JumpStart configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Deploy the JumpStart configuration.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
该辅助程序会渲染并应用已发布的 JumpStartModel 资源,而不会将填入的发布值写入磁盘。
使用 SGLang 或 vLLM 部署
当您需要直接控制服务运行时,请选择 SGLang 或 vLLM。在配置部署之前,请查看 reflection-beam-sglang.yaml 清单模板或 reflection-beam-vllm.yaml 清单模板。示例 README 是已发布参数值和命令的权威来源。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the HyperPod Beam directory.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the selected configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Deploy Beam, and wait for a terminal deployment state.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
将
sglang替换为vllm以使用 vLLM。该辅助工具会验证所选设置,在不将已发布参数值写入磁盘的情况下应用渲染后的清单,使用固定超时时间等待,并在部署失败时打印诊断信息。
调用 Beam
使用已发布的模型请求架构调用 JumpStart 端点。对于 SGLang 或 vLLM,请使用 HyperPod 示例中包含的有界冒烟测试。
调用已部署的端点
- Install the sample client dependency.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Run a private health check and short request with the recommended starting sampling settings.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
对于 vLLM 部署,将
sglang替换为vllm。该辅助工具会选择一个就绪的工作节点,开启临时端口转发,检查端点运行状况,发送请求,然后关闭端口转发。
响应示例如下:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
对于经过身份验证的 Inference Gateway,请使用 HyperPod 示例 README 中的 bearer token 流程。请勿将凭证放入源代码、清单或命令历史记录中。
测量并调整性能
- 使用符合预期并发量、具有代表性的编码和工具使用请求,对每条服务路径进行重复测试。
- 记录 Beam 模型版本、映像摘要、实例类型、精度、上下文长度、并行度、服务参数、缓存状态和测试次数。
- 测量请求成功率、首个 token 的 p50 和 p95 时间、每个输出 token 的耗时、端到端延迟,以及聚合输出 token 吞吐量(每秒)。
- 根据这些结果调整批量大小、KV 缓存分配、副本数量、自动扩缩以及模型和映像缓存。
- 更改精度或量化设置后,重新检查输出质量。
清理
测试完成后删除资源,以避免持续产生费用。
- 对于 SageMaker JumpStart 实时端点,请按照 SageMaker JumpStart 部署示例 README 中的清理说明操作。
- 对于在 Amazon SageMaker HyperPod Inference 上运行的 JumpStart、SGLang 或 vLLM,请按照 HyperPod Inference 部署示例 README 中的清理说明操作。
- 删除为本指南创建的专用 HyperPod 或 Amazon EKS 集群。
- 删除未使用的缓存权重、镜像制品、负载均衡器、日志组、临时 IAM 角色和捕获的推理数据。
结论
Reflection Beam 为开发者提供了一款开放权重模型,专为智能体编程和多步骤任务而设计。若要采用完全托管式部署,可从 SageMaker JumpStart 实时端点开始。当您需要 Kubernetes 原生基础设施控制,又不想管理服务容器时,可使用搭载 JumpStart 的 SageMaker HyperPod Inference;需要自定义运行时,则可选择 SGLang 或 vLLM。
请使用 SageMaker JumpStart 部署示例或 HyperPod Inference 部署示例,然后按照说明操作。
如需进一步了解 Reflection AI 及其开放智能愿景,请访问 Reflection AI,并阅读 Introducing Beam。
资源
- Reflection Beam 检查点变体:BF16、FP8 和 NVFP4
- SageMaker JumpStart 部署示例
- 搭载 JumpStart、vLLM 和 SGLang 的 HyperPod Inference 部署示例
- 将 SageMaker JumpStart 基础模型部署到 HyperPod Inference
- Amazon SageMaker Inference 2026 年迄今发布内容回顾
作者简介

Clement Perrot
Clement 是 Reflection AI 的应用 AI 创始成员。加入 Reflection AI 之前,他曾在 AWS 生成式 AI 创新中心工作,并创办过 AI 和消费级硬件初创公司,其中两家公司被收购。

Florent Gbelidji
Florent 是 Reflection AI 的开源工程负责人和技术团队成员。加入 Reflection AI 之前,他负责 Hugging Face 与 AWS 的云合作,并曾担任机器学习工程师,帮助企业构建开源 AI 解决方案。

Daniel Quang
Daniel 是 AWS 前沿 AI 初创企业团队的解决方案架构师,帮助全球规模最大、最具战略意义的生成式 AI 初创企业在 AWS 上扩展基础设施。他拥有加州大学欧文分校计算机科学博士学位,研究方向为机器学习和生物信息学。

Hadrien Almela
Hadrien 是 AWS 初创企业团队的高级前沿 AI 客户经理,帮助顶尖 AI 初创企业构建技术集成和全球市场拓展合作伙伴关系。他在初创企业领域拥有八年经验。Hadrien 住在加利福尼亚州旧金山,喜欢潜水、冲浪和前往异国旅行。

Dan Ferguson
Dan 是 AWS 生成式 AI 高级全球专业解决方案架构师,常驻纽约。他帮助客户高效、有效且可持续地集成机器学习和生成式 AI 工作负载。

Daniel Wirjo
Daniel 是 AWS 的解决方案架构师,专注于 AI 和 SaaS 初创企业。作为一名前初创企业 CTO,他乐于与创始人和工程负责人合作,推动企业在 AWS 上实现增长与创新。工作之余,Daniel 喜欢手捧咖啡散步、欣赏自然并学习新理念。

Sureshkumar Natarajan
Sureshkumar 是 Amazon Web Services 的高级技术客户经理。他帮助企业客户加速云现代化进程,并参与新一代开发者体验技术领域社区,为 AWS Transform custom 提供支持。
来源:AWS Machine Learning Blog · aws.amazon.com