Amazon SageMaker AI 多轮强化学习实战指南
Multi-Turn Reinforcement Learning on Amazon SageMaker AI: A hands-on guide
AWS 介绍如何在 Amazon SageMaker AI 上训练多轮强化学习模型,并以 Wordle 智能体演示从部署、准备数据到训练和评估的完整流程。使用 gpt-oss-20b 时,模型在默认推理强度下对留出单词的解题率从 61% 提升至 84%,训练 token 费用约 $339;低推理强度下解题率从 15% 提升至 69%。
文章展示了如何用整段任务结果设计强化学习奖励,并梳理部署、训练与评估中的常见故障,方法可迁移到企业多步骤工作流。
大多数微调教会模型针对单个提示生成更好的答案。智能体任务则不同。处理费用报销或对支持工单进行分流的智能体需要执行一系列操作,每一步都取决于之前发生的情况。很少存在唯一正确的操作序列可供模仿,而唯一可靠的反馈是整个序列是否成功。监督微调没有这类标签,单轮强化学习也无法将结果归因于三步之前做出的决策。
Amazon SageMaker AI 上的多轮强化学习(MTRL)正是利用这一信号训练模型。SageMaker AI 通过 AWS Lambda 转发器向托管在 Amazon Bedrock AgentCore 上的智能体发送提示,或发送到你自己的基础设施上,例如 Amazon Elastic Kubernetes Service (Amazon EKS)、Amazon Elastic Compute Cloud (Amazon EC2) 或 AWS Fargate。本文示例使用 AgentCore。智能体调用正在训练的策略模型,在你的环境中根据任务需要执行任意多轮操作,并在一个回合结束时报告一次奖励。你无需指定正确的操作轨迹,只需说明如何为结果评分。
本文以 Wordle 为例。这是一款猜词游戏,玩家有六次机会猜出一个隐藏的五字母单词。每次猜测后,如果字母位置正确,该字母会变成绿色;如果该字母在单词中但位置不对,则变成黄色;如果该字母不在单词中,则变成灰色。Wordle 很适合用于 MTRL,因为它的规则不多,每次猜测都取决于上一次的反馈,而且结果可以客观评分。Wordle 是一个教学示例,而前沿模型已经很擅长玩这款游戏。实际上,你可以使用 MTRL,让小型、低成本模型擅长完成特定于业务的多步骤任务,例如公共模型从未接受过训练的内部工作流程。同一条流水线也适用于这类场景。
在我们的实验中,使用 MTRL 后,gpt-oss-20b 在默认推理强度下对留出单词的猜中率从 61% 提升到 84%;在训练时使用的低推理强度下,猜中率则从 15% 提升到 69%,训练 token 费用约为 $339。本文将端到端介绍整条流水线:将智能体和奖励函数部署到 AgentCore、准备数据集、训练、在 MLflow 中监控,以及在服务设置下进行评估。我们还会分享奖励设计中的错误和训练失败经历。你的数据集、智能体和训练后的模型都保留在你的 AWS 账户中,不会用于训练基础模型。所有代码都位于随文提供的 aws-samples 代码库中。
解决方案概览
该系统由两部分组成。SageMaker AI 负责训练任务和策略模型。AgentCore 托管智能体、Wordle 环境和奖励函数。下图展示了它们的连接方式。
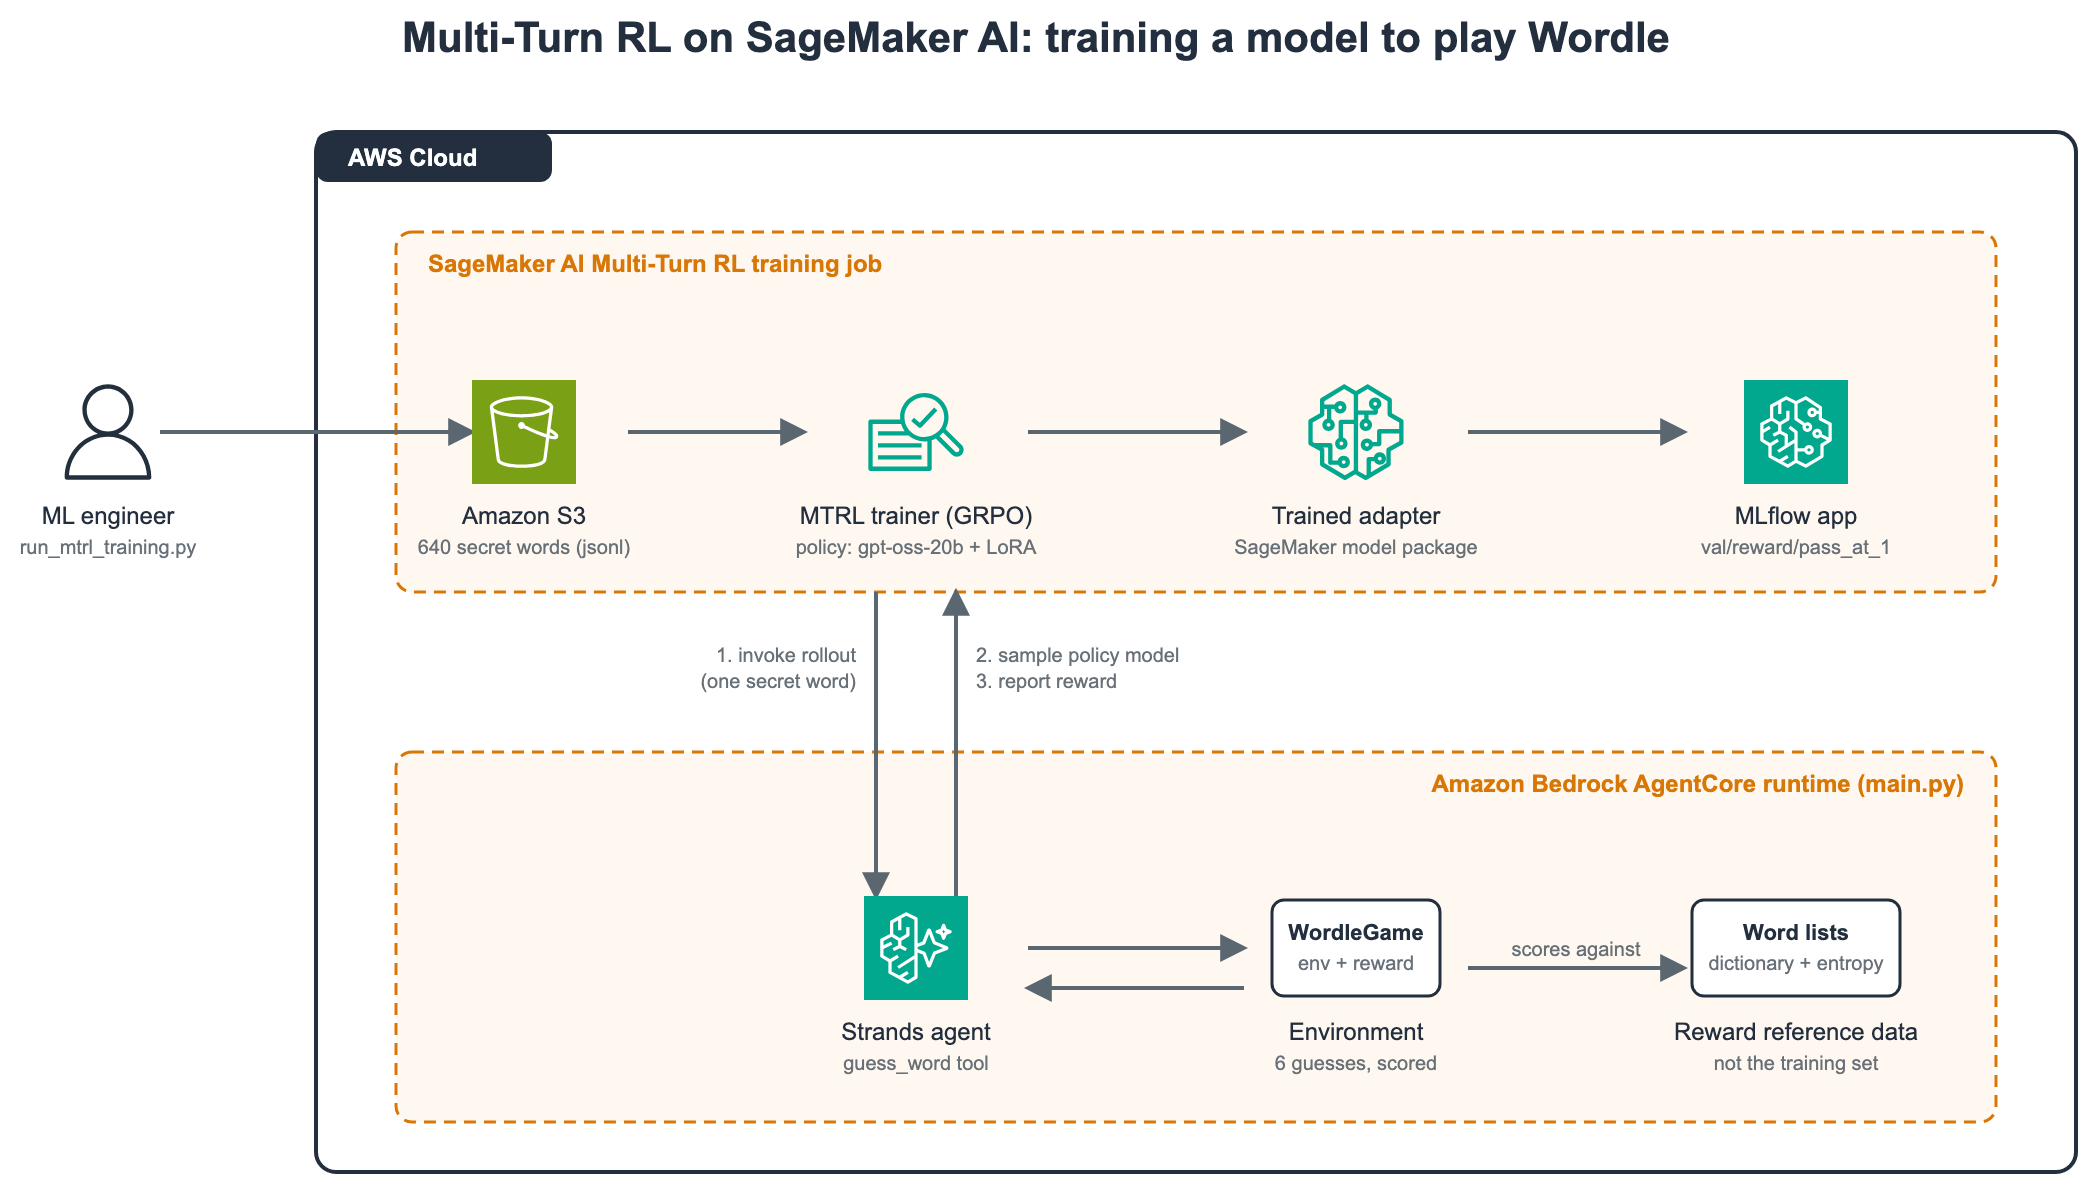
图 1:SageMaker AI 上的 MTRL;训练任务在每次 rollout 中调用一次由 AgentCore 托管的智能体,以采样策略模型、进行游戏并报告奖励
每次 rollout 中,MTRL 服务都会调用 AgentCore runtime(Amazon Bedrock AgentCore 的一项功能),并传入一条训练数据,其中包含一个秘密单词。runtime 中的 Strands agent 会通过 SageMaker Job Runtime 的 OpenAI 兼容端点调用策略模型。模型通过一个工具 guess_word 最多猜六次;每次猜测后,环境都会返回每个字母的反馈,以及已知信息的摘要。游戏结束后,agent 会返回一个奖励。组相对策略优化(GRPO)会利用同一单词多个 rollout 的奖励差异,更新策略模型上的低秩适配(LoRA)适配器。
以下三项设计要点对后续内容很重要:
- agent 和奖励位于同一处。部署到 AgentCore 的单个 Python 文件包含环境、工具和评分函数。
- 数据集只包含秘密单词。agent 附带的单词列表由开源 SCOWL 单词列表构建,仅用于评分。
- 奖励主要取决于结果。猜中可得 1.05–1.55 分,具体取决于速度;失败得 -0.5 分;未能做出有效猜测得 -1.5 分。另有一项较小的塑形奖励,用于奖励各等级中的良好策略。
支持的模型和 AWS 区域
MTRL 是无服务器服务:你只需选择基础模型,服务便会配置训练和采样基础设施。在撰写本文时,它支持以下基础模型,每种模型均使用 LoRA 适配器进行训练:
| 基础模型 | AWS 区域 |
| Amazon Nova 2 Lite | 美国东部(弗吉尼亚北部)(us-east-1)、美国西部(俄勒冈)(us-west-2) |
GPT-OSS-20B |
美国东部(弗吉尼亚北部)(us-east-1)、美国西部(俄勒冈)(us-west-2) |
| Gemma 4 31B(指令微调版) | 美国西部(俄勒冈)(us-west-2) |
| Qwen 3.6 27B | 美国西部(俄勒冈)(us-west-2) |
我们选择了 GPT-OSS-20B,因为在这四种模型中,它的每 token 价格最低,而且可以按请求控制其推理力度。当前列表请参阅 MTRL 文档。
定价
你无需选择实例或规划集群规模。你按百万 token 付费,分为三个计费维度,价格取决于基础模型:
- Prefill:策略模型处理的输入 token。由于每一轮都会重新读取历史记录,因此这些 token 会在多轮任务中累积。
- Sample:策略模型生成的 token,包括推理 token。
- Train:在反向传播中处理、用于更新 LoRA 适配器的 token。
这次 100 步运行在 12 小时 40 分钟内完成了 105,486 次 rollout,消耗了 491.6 million 个 prefill token、159.7 million 个 sample token 和 643.3 million 个 train token。按撰写本文时 GPT-OSS-20B 在美国东部(弗吉尼亚北部)区域(us-east-1)的标价计算,费用约为 $339:
| 维度 | Token 数 | 每 1M 的价格 | 费用 |
| Prefill | 491,616,806 | $0.12 | $58.99 |
| Sample | 159,737,098 | $0.30 | $47.92 |
| Train | 643,308,554 | $0.36 | $231.59 |
| 总计 | 1,294,662,458 | $338.50 |
Train 维度占主要部分,且费用会随轨迹长度增加,因此缩短游戏时长、减少冗长推理都能降低费用。AgentCore runtime 会根据 agent 使用的 vCPU 和内存另行计费。这次运行的费用约为 $79,依据是 runtime 在 us-east-1 按标价计算的 Amazon CloudWatch 使用指标。DescribeJob 会在 BillableTokenUsage 下报告 token 数量。当前费率请参阅 Amazon SageMaker AI 定价。
先决条件
要按照本指南操作,你需要满足以下条件。另请参阅 MTRL 先决条件。
- Python 3.10 或更高版本、uv、Node 20 或更高版本,以及 AgentCore CLI (
npm install -g @aws/agentcore)。有关安装和 CLI 所需 IAM 权限,请参阅 开始使用 Amazon Bedrock AgentCore。 - 在启动作业的机器上安装 botocore 1.43.37 或更高版本。这是首个包含
AgentRFTCreateJob操作的版本。 - 两个 AWS Identity and Access Management (IAM) 角色,详见步骤 1。
- 一个与代理位于同一区域的 Amazon Simple Storage Service (Amazon S3) 存储桶。训练作业也必须在该区域运行,因为
CreateJob不接受跨区域运行时 ARN。
步骤 1:创建 IAM 角色
MTRL 使用两个角色,其中一个角色的信任策略未在 SageMaker AI 的常规文档中提及。
代理运行时角色。 agentcore deploy 会为你创建此角色。该角色信任 bedrock-agentcore.amazonaws.com,并需要 AmazonSageMakerJobRuntimeAccess 托管策略,以便代理调用策略模型并报告奖励。示例仓库中的 CDK 堆栈会自动附加此策略。
训练作业角色。 你需要创建此角色。它必须同时信任 job.sagemaker.amazonaws.com 的 sts:AssumeRole 和 sts:TagSession,并且需要 AmazonSageMakerJobFullAccess 托管策略。
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "job.sagemaker.amazonaws.com"},
        "Action": ["sts:AssumeRole", "sts:TagSession"]
    }]
}
注意: 信任主体是 job.sagemaker.amazonaws.com,而不是 sagemaker.amazonaws.com。使用通用主体时,CreateJob 会报错“Could not assume role”,并且只有在重试后,错误消息才会指出正确的主体。
步骤 2:将代理部署到 Amazon Bedrock AgentCore
克隆示例仓库,在 Wordle/agentcore/aws-targets.json 中设置你的账户和区域,然后进行部署:
git clone https://github.com/aws-samples/sample-multi-turn-rl-wordle
cd sample-multi-turn-rl-wordle/Wordle
agentcore validate
agentcore deploy
CLI 会为运行时的 Linux ARM64 平台构建代理依赖项,创建附加了 AmazonSageMakerJobRuntimeAccess 的执行角色,并通过 AWS CloudFormation 进行部署。我们建议使用 CLI,而不是在控制台上传代码包;后者很容易导致约 700 MB 的编译依赖项或策略附件配置错误。请记下输出中的运行时 ARN,供训练作业使用。
图 2:Amazon Bedrock AgentCore 控制台中的 Wordle 代理运行时,状态为 Ready
运行时会从 agentcore.json 读取两个环境变量。REASONING_EFFORT=low 会在每次请求中为策略模型设置 reasoning_effort。在我们的评估作业中,与 medium 相比,low 每局使用的样本 token 减少了 63% 到 83%。REASONING_PROMPT_HINT=true 还会在系统提示中添加“Reasoning: low”,gpt-oss 正是通过 Harmony 聊天格式读取此设置。两个变量都不会向模型泄露秘密单词的任何线索。
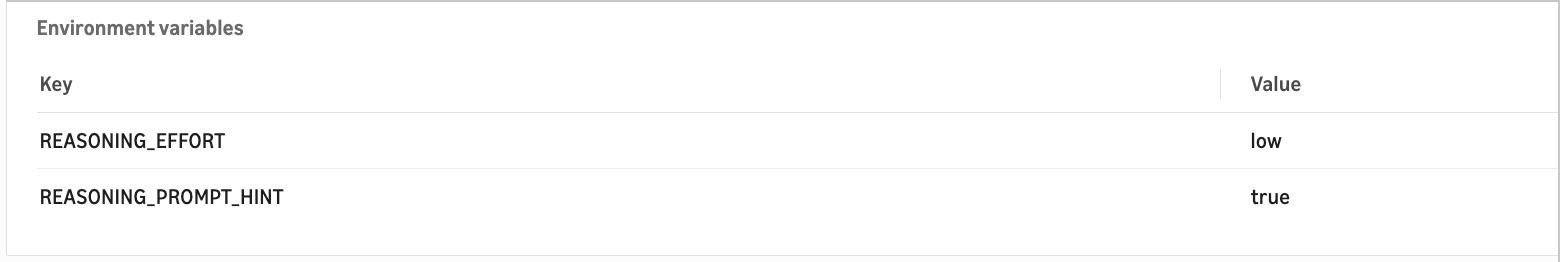
图 3:运行时环境变量,其中 REASONING_EFFORT 设置为 low
代理只有一个文件 main.py。简化后,其入口点如下所示。对于你自己的任务,需要更改任务解析、工具和奖励:
app = BedrockAgentCoreApp()

@app.entrypoint  # outermost: starts the HTTP server AgentCore invokes
@sagemaker_rft_handler  # reports the returned reward to SageMaker AI
def handle_rollout(payload):
    prompt, answer = parse_task(payload["prompt"])
    game = WordleGame(answer)

    @tool
    def guess_word(guess: str) -> str:
        """Submit a 5-letter Wordle guess and get feedback."""
        return game.guess(guess)

    agent = Agent(model=build_model(), system_prompt=SYSTEM_PROMPT, tools=[guess_word])
    agent(prompt)
    return {"reward": game.final_reward()}
重要: sagemaker_rft_handler 装饰器本身不会启动 HTTP 服务器。请用 BedrockAgentCoreApp 和 @app.entrypoint 将它包装起来,并将入口点装饰器放在最外层。否则,每次调用都会在 30 秒后超时。
步骤 3:验证运行时
在耗费 GPU 时间之前,请使用与训练服务发送的负载格式相同的负载,确认整个调用链正常工作。仓库中提供了一个示例:Wordle/payload.json:
{
  "prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"beach\", \"id\": \"smoke-test\"}",
  "metadata": {
    "jobArn": "arn:aws:sagemaker:us-east-1:111122223333:job/AgentRFT/smoke-test",
    "rolloutId": "r1"
  }
}
虚假的作业 ARN 预期会失败,而其失败方式正是验证依据。请先将其中的账户 ID 替换为你自己的:对于属于其他账户的作业 ARN,服务会在检查作业是否存在之前返回 403,这看起来像是 IAM 配置有误。在 Wordle 目录中运行:
ACCOUNT=$(aws sts get-caller-identity --query Account --output text)
sed "s/111122223333/$ACCOUNT/" payload.json > /tmp/payload.json

aws bedrock-agentcore invoke-agent-runtime \
  --agent-runtime-arn <RUNTIME_ARN> \
  --runtime-session-id smoke-test-$(date +%s)000000000000000 \
  --payload fileb:///tmp/payload.json /dev/stdout
在运行时的 Amazon CloudWatch 日志中,你会看到智能体解析提示词、向 Job Runtime 端点进行身份验证,并收到一条显示“Could not find job.”的 400 错误。此失败确认了提示词解析、身份验证和错误报告均正常工作。由于智能体未能触及策略模型,命令本身会打印 {“reward”: -1.5}。显示“not authorized to access this resource”的 403 错误意味着作业 ARN 仍指向另一个账户。若发生 30 秒超时,则表示 HTTP 服务器未启动(请参阅步骤 2 中的“重要提示”)。
步骤 4:准备数据集
MTRL 数据集不包含目标响应、转录文本或标签。每一行都是智能体要尝试完成的一项任务。以下是训练文件的前三行:
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"riser\", \"id\": \"wordle_train_0000\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"swoon\", \"id\": \"wordle_train_0001\"}"}
{"prompt": "{\"prompt\": \"Guess the 5-letter word\", \"answer\": \"dirty\", \"id\": \"wordle_train_0002\"}"}
服务会读取 prompt 列(或第一列),并将其中的字符串原封不动地传递给你的智能体,不进行解析。我们将该字符串设为一个包含三个字段的小型 JSON 对象:
- prompt: 智能体向策略模型展示的指令,每一行都相同。
- answer: 秘密单词。只有环境和奖励函数会使用它。策略模型看不到它。
- id: 行 ID,用于在日志中将一次 rollout 追溯到其源行。
示例代码库中的 make_dataset.py 会从答案列表中抽取 640 个训练单词(5 个完整的 128 条数据批次)和 128 个验证单词,且二者不重叠,因此验证集求解率可以衡量泛化能力。该服务还支持 Apache Parquet、JSON 数组和 CSV。将两个文件都上传到 Amazon S3:
uv run python make_dataset.py
aws s3 cp training-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/train/
aws s3 cp validation-data.jsonl s3://<YOUR_BUCKET>/wordle-mtrl/validation/
由于服务不会检查 prompt 字符串,生产任务可以将完整的消息列表、工具配置或奖励规范打包到其中。示例请参阅 MTRL 文档,其中还介绍了如何保护字符串中的敏感内容。
步骤 5:启动训练作业
启动器使用 sagemaker-train SDK 中的 MultiTurnRLTrainer 类。将其指向步骤 2 中的运行时 ARN、步骤 1 中的角色、步骤 4 中的数据集,以及用于指标的 MLflow 应用。MLflow 应用是必需的,因此如果你还没有,请先使用 aws sagemaker create-mlflow-app 创建一个:
uv run python run_mtrl_training.py \
  --model openai-reasoning-gpt-oss-20b \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --train-dataset s3://<YOUR_BUCKET>/wordle-mtrl/train/training-data.jsonl \
  --val-dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/output/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
启动器会覆盖三个超参数,其余参数均保留 gpt-oss-20b 的默认值。它将 sampling_max_tokens 设为 8192,即服务的最大值,因为在默认值 4096 下,gpt-oss 经常在推理期间、首次调用工具之前就耗尽令牌。它将 max_epochs 设为 20,将 max_steps 设为 100:640 行数据在默认 global_batch_size 128 下每个 epoch 有 5 个步数;在默认 group_size 8 下,每个步数会进行 1,024 场对局。作业会依次经过 Starting、Downloading 和 Pending 状态,然后进入 Training 状态。开始训练后,你的 AgentCore 运行时便会开始接收 rollout 调用。
重要提示:作业运行期间不要重新部署智能体。重新部署会重启运行时,正在进行的 rollout 将无法收到采样请求,服务会因此判定整个作业失败。
步骤 6:在 MLflow 中监控训练
服务会在每个步数记录奖励、令牌和轮次数统计数据,并每隔 val_every 个步数运行一次验证。需要关注的指标是 val/reward/pass_at_1,即成功解出留出单词的比例。每次成功至少得分 1.01,因此超过了服务的 success_threshold 1.0 阈值,并会计入 pass@1。下图根据本次运行的 MLflow 历史记录绘制:
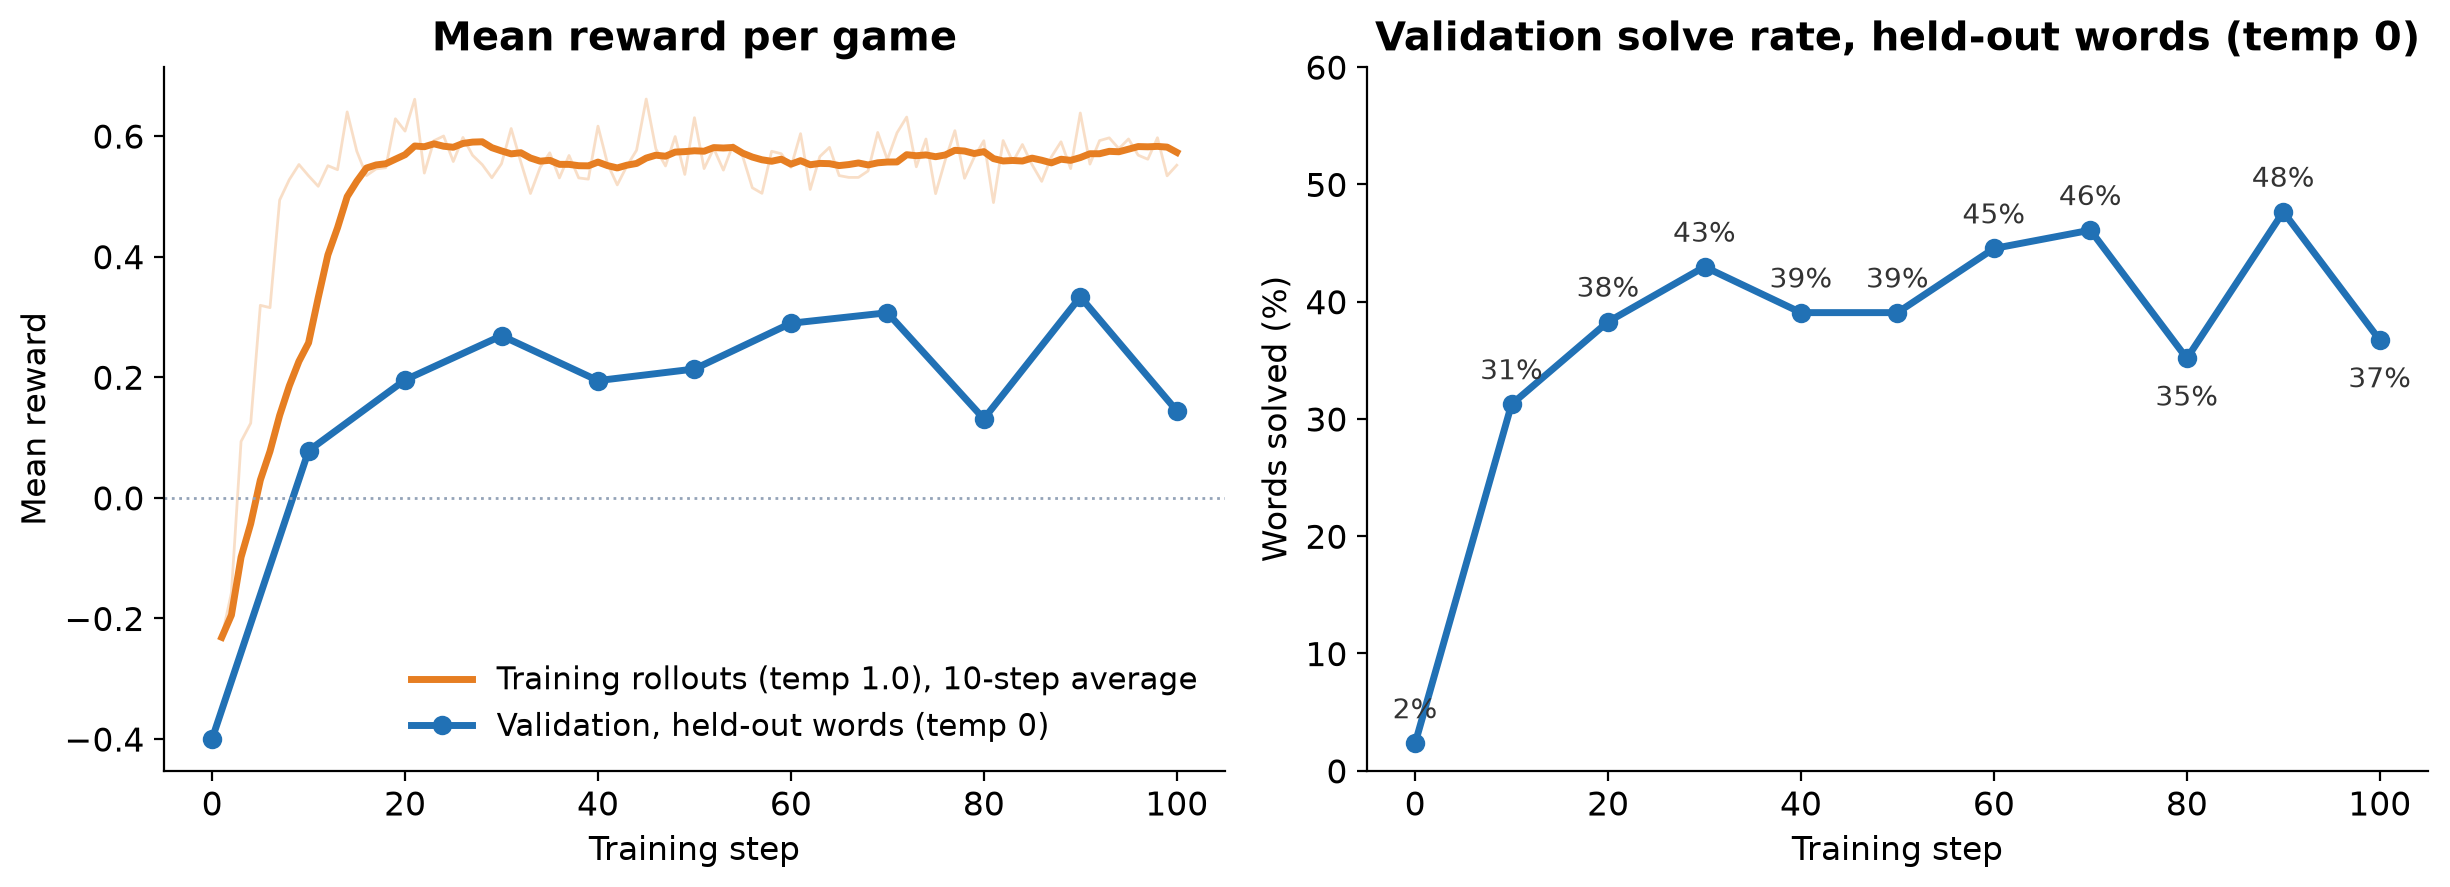
图 4:100 步运行的训练曲线,左侧为每场对局的平均奖励,右侧为验证集求解率
训练奖励在 15 步内升至约 +0.57,并保持在该水平。验证奖励较低,主要是因为温度设为 1.0 而非 0,并非过拟合(见步骤 7)。前 10 步中,验证解题率从 2% 跃升至 31%,之后在 35% 至 48% 之间波动。对于 128 个单词而言,这些波动大多只是噪声。我们没有测试在服务设置下增加步数是否有帮助。
运行时在 CloudWatch 中记录的 OpenTelemetry 跟踪信息包含每一轮模型对话和工具调用。以下是训练后的模型在一次评估任务中进行的一局游戏(中等推理强度,温度 1.0),其中推理内容已删减。秘密单词是 PASTE:
[model] Reasoning: [...] "CRANE" has 5 distinct letters: C,R,A,N,E. [...]
We'll guess "CRANE".
Tool call: guess_word(guess="CRANE")
[tool] Guess 1/6: CRANE -> C=gray, R=gray, A=yellow, N=gray, E=green
Current Knowledge:
- Correct Position (Green): _ _ _ _ E
- In Word, Wrong Position (Yellow): 'A' (at least 1)
- Not in Word (Gray): C, N, R
- Guesses Remaining: 5
[model] Reasoning: [...] "ALIVE": ends with E, includes A. Letters not C,N,R.
Tool call: guess_word(guess="ALIVE")
[tool] Guess 2/6: ALIVE -> A=yellow, L=gray, I=gray, V=gray, E=green
[model] Reasoning: [...] So positions not 1 or 3 for A. Positions left: 2,4
for A. [...] We might guess "HASTE"? [...]
Tool call: guess_word(guess="HASTE")
[tool] Guess 3/6: HASTE -> H=gray, A=green, S=green, T=green, E=green
[model] Reasoning: We have the word: _ASTE. [...] "PASTE" is a word. PASTE
fits. Also "WASTE" also fits [...] Choose "PASTE" maybe.
Tool call: guess_word(guess="PASTE")
[tool] Guess 4/6: PASTE --- all green. Correct, you solved it!
来自 AgentCore 运行时跟踪信息的一次训练模型运行记录。模型会保留绿色字母的位置,不会重复使用灰色字母,并利用每个黄色字母排除相应位置,尽管训练数据中并没有任何内容教它这些做法。
步骤 7:在服务设置下评估训练后的模型
任务完成后,其在 SageMaker AI Studio 中的页面会显示状态,以及包含训练后模型的模型包组。DescribeJob,其中 JobCategory 设为 AgentRFT,会返回输出模型包 ARN 和计费 token 数量。
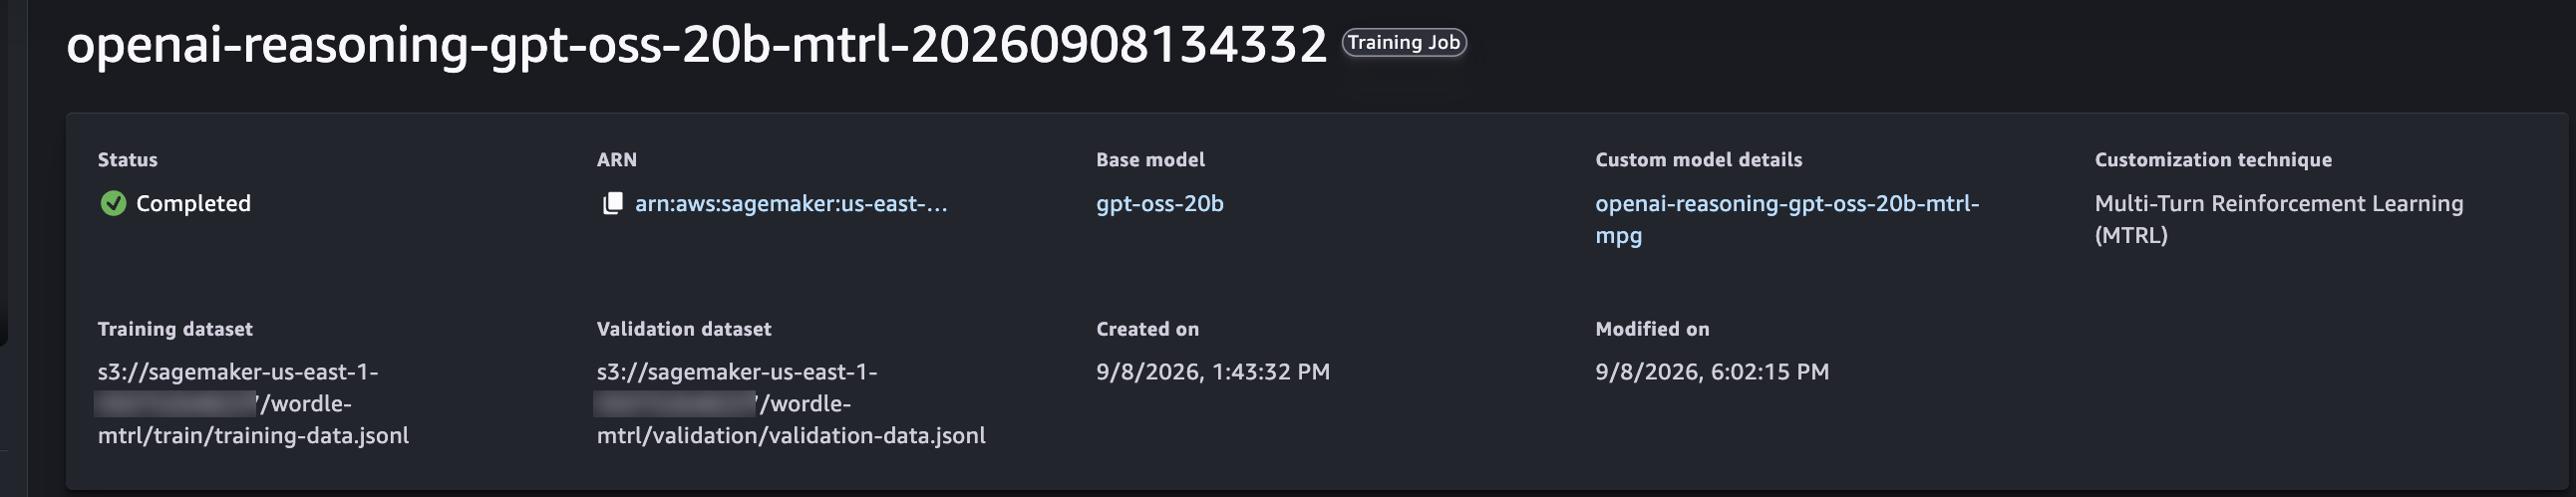
图 5:SageMaker AI Studio 的 Jobs、Training、Multi-turn RL 选项卡中的已完成训练任务
评估任务(将 JobCategory 设为 AgentRFTEvaluation)会通过相同的 AgentCore 运行时和奖励机制,在基础模型或训练后的模型包上运行评估提示,并将 eval/reward/pass_at_1 记录到 MLflow。与训练验证不同,你可以设置温度。由于默认配额一次只允许运行一个评估任务,因此存储库的启动器会依次运行评估(你可以申请提高配额):
uv run python run_mtrl_eval.py --runs base:1.0 trained:1.0 \
  --model-package-arn <OUTPUT_MODEL_PACKAGE_ARN> \
  --agent-runtime-arn <RUNTIME_ARN> \
  --role-arn arn:aws:iam::<ACCOUNT>:role/<JOB_ROLE> \
  --dataset s3://<YOUR_BUCKET>/wordle-mtrl/validation/validation-data.jsonl \
  --s3-output-path s3://<YOUR_BUCKET>/wordle-mtrl/eval/ \
  --mlflow-app-arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>
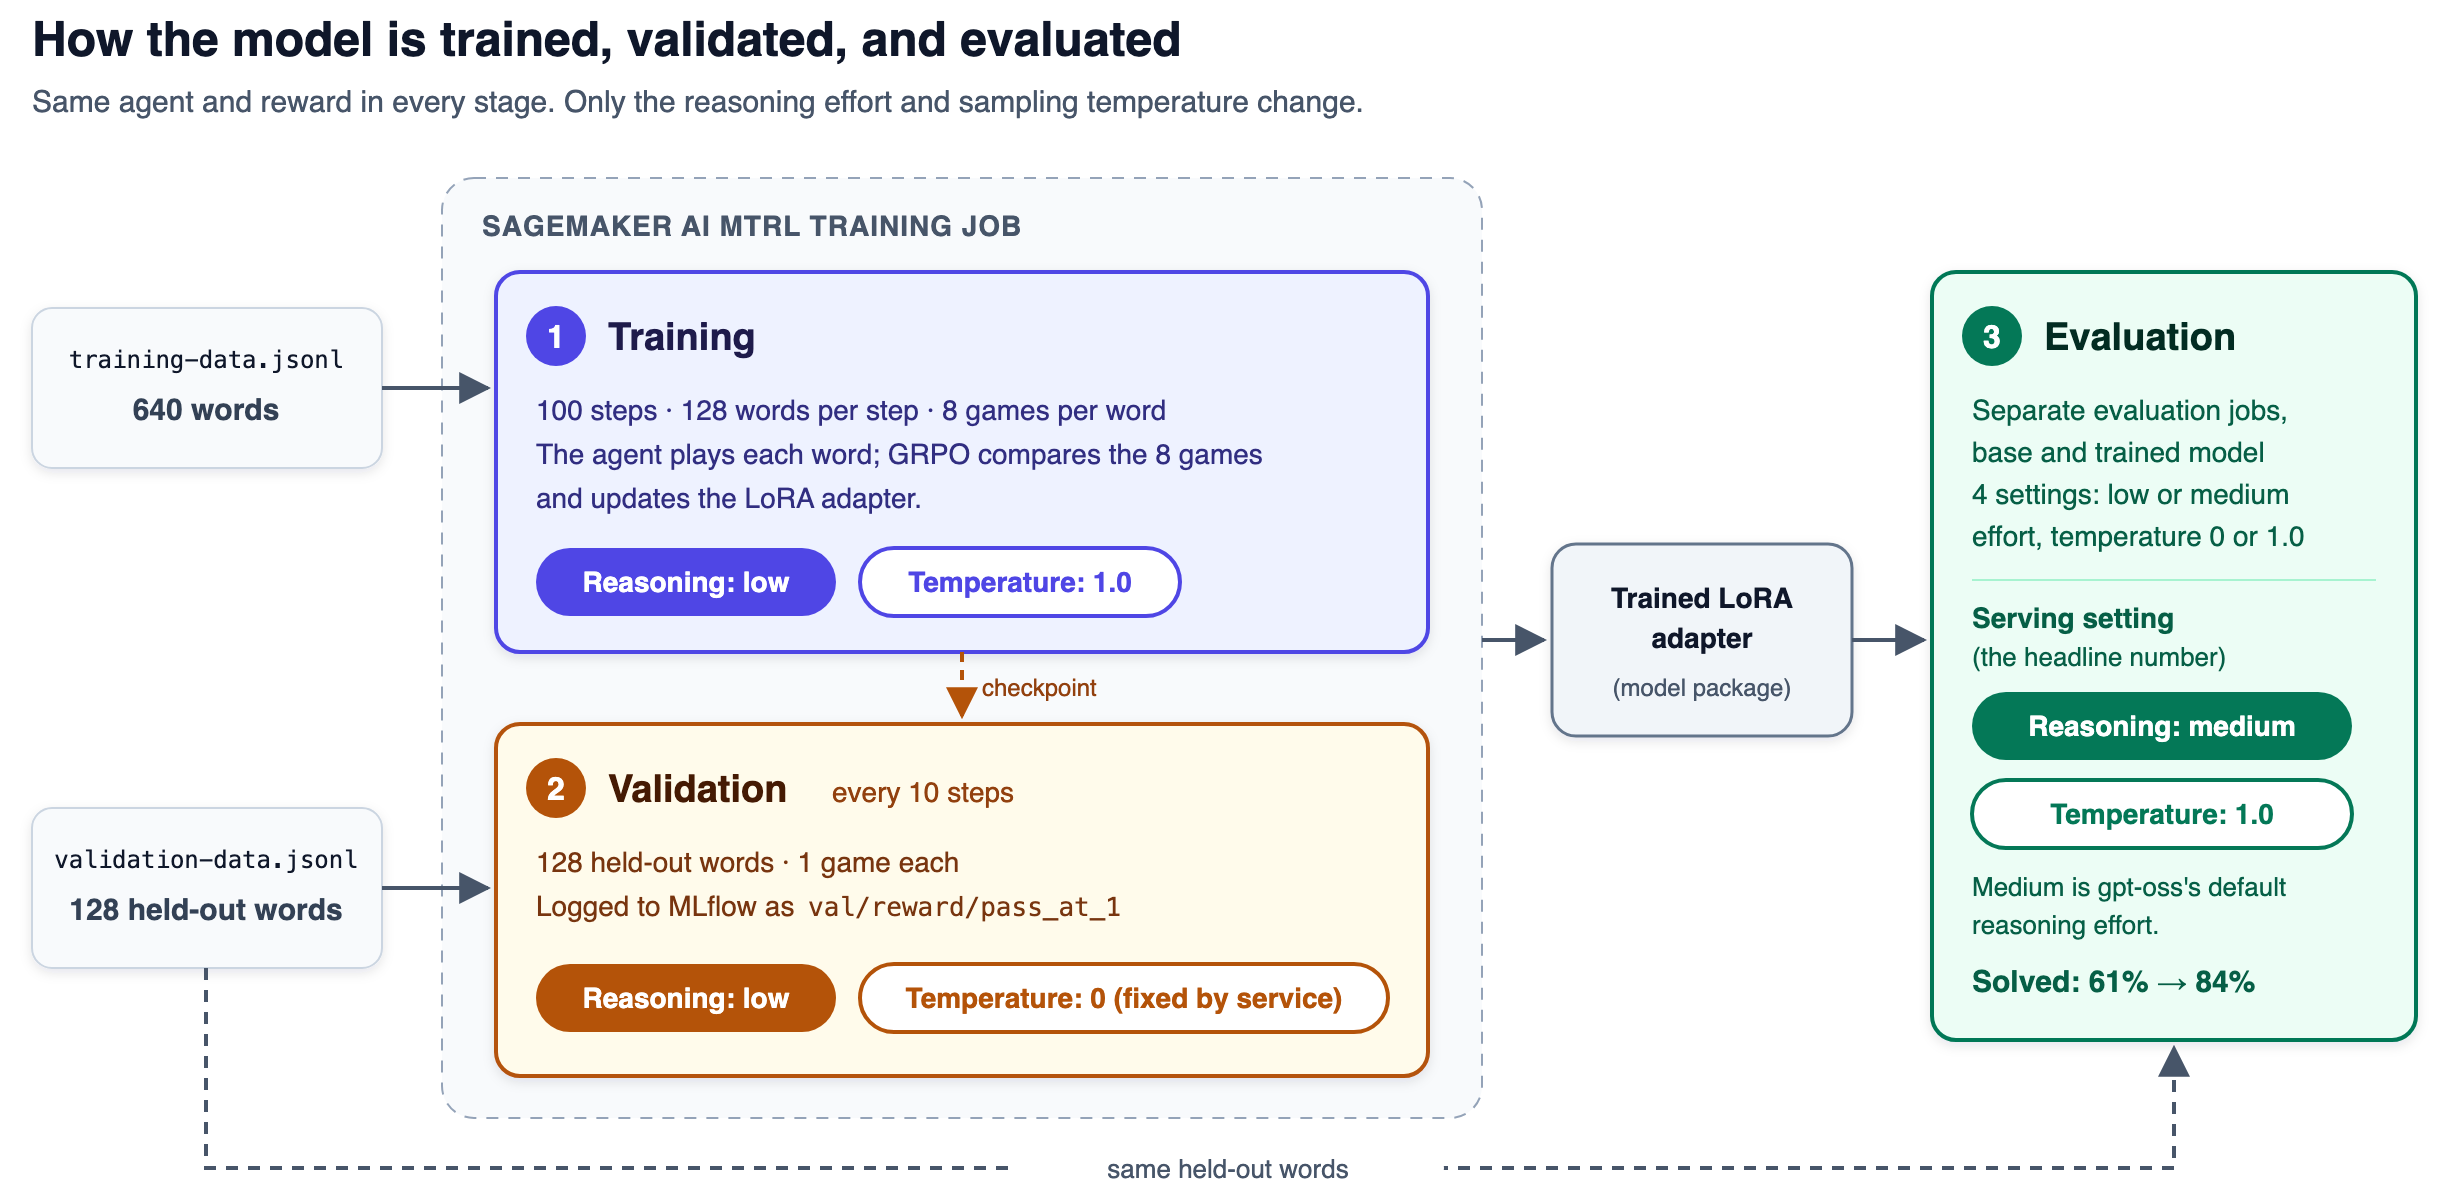
图 6:各阶段的推理强度和采样温度;训练任务将验证温度固定为 0,并固定部署时的推理强度,而评估任务则允许你自行选择
每次针对 128 个单词的评估耗时四到七分钟。推理强度由智能体的环境变量决定,因此要更改它,需编辑 REASONING_EFFORT,重新部署并进行评估。我们在低、中两种推理强度以及温度 0 和 1.0 下评估了两个模型:
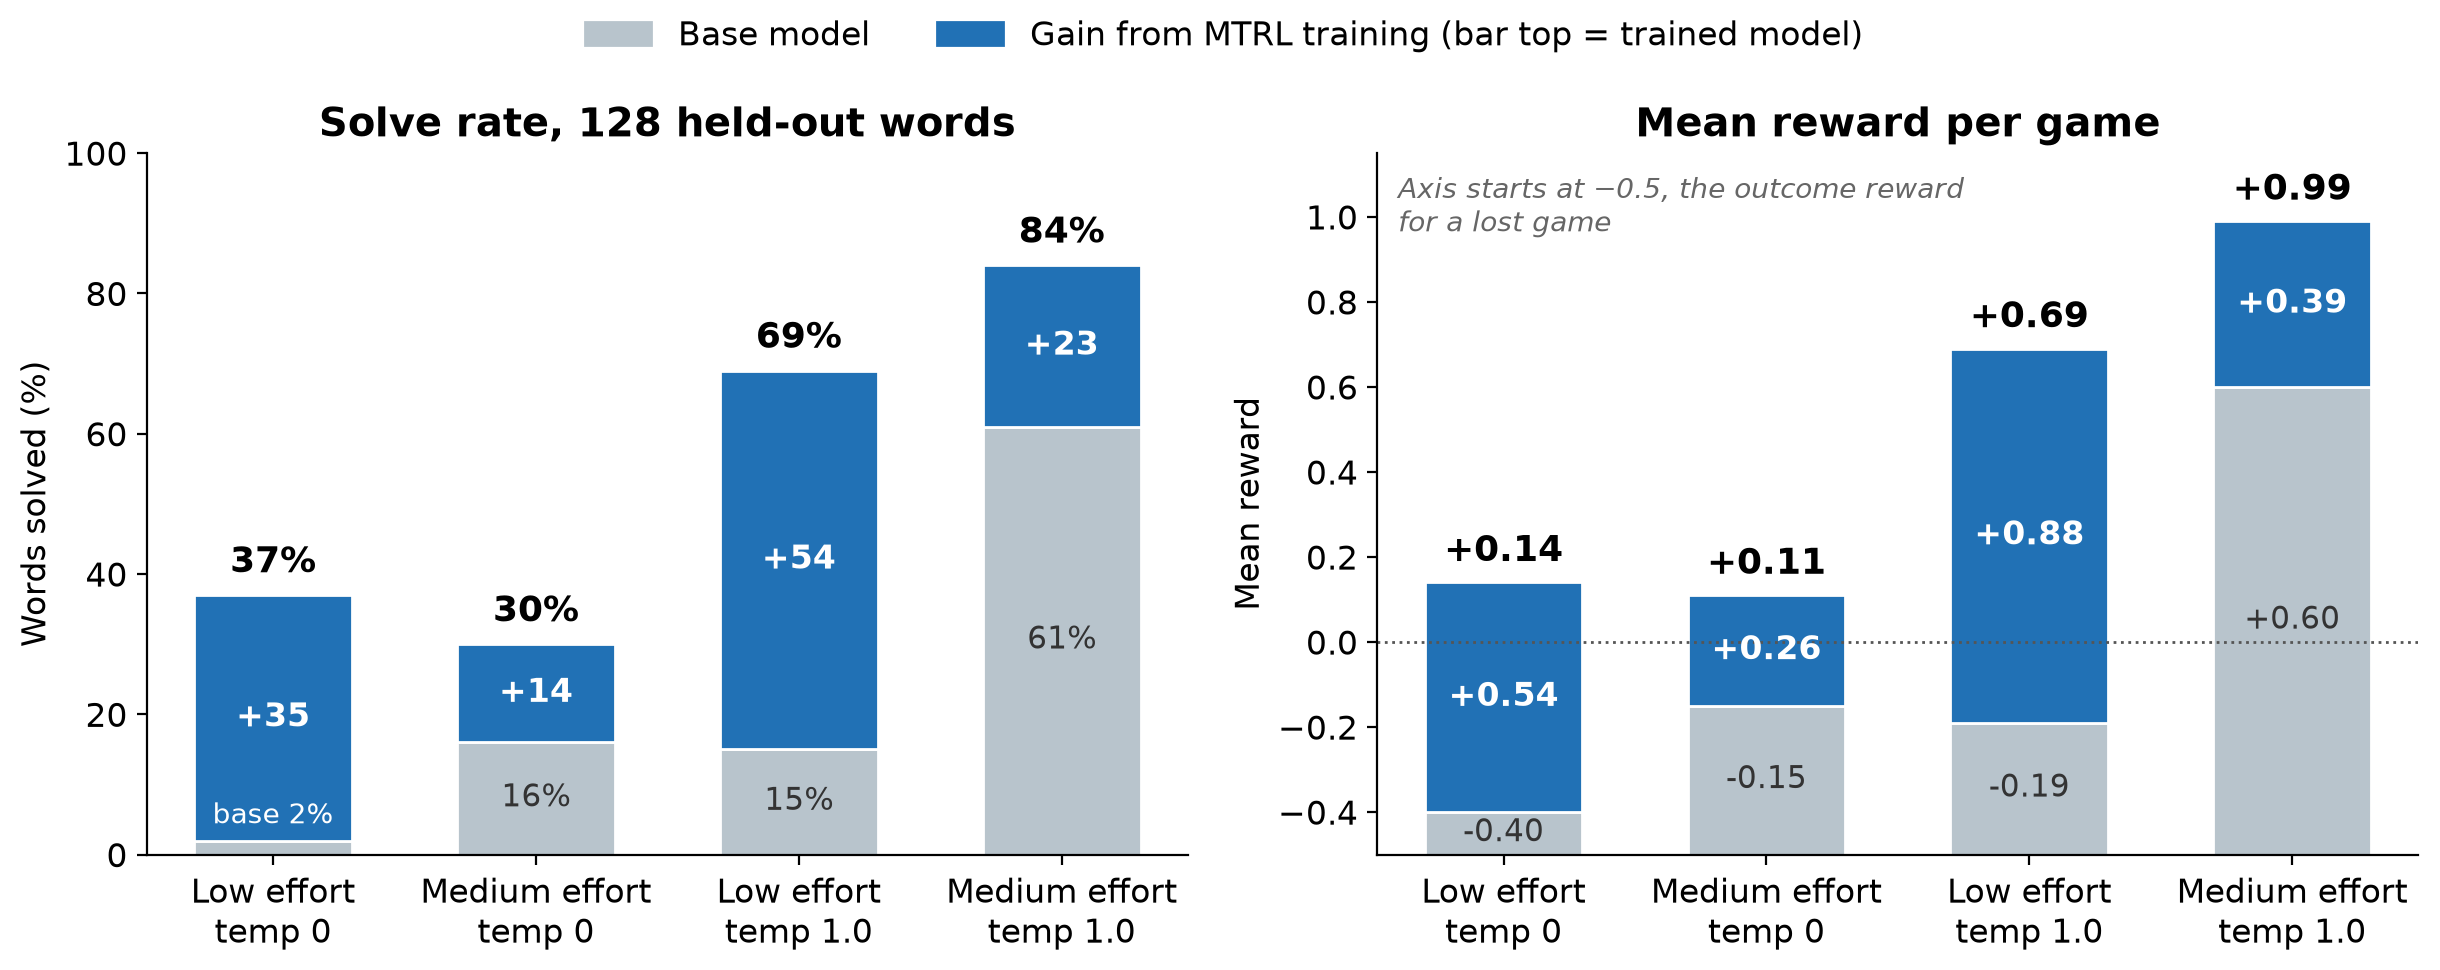
图 7:四种解码设置下基础模型与训练后模型的对比,左侧为解题率,右侧为每局游戏的平均奖励
每个柱状条的灰色部分表示基础模型,蓝色部分表示训练带来的提升。低推理强度、温度为 0 的组合对应训练任务在第 0 步和第 100 步的验证结果。中等推理强度、温度为 1.0 时训练后模型的结果是两次运行的平均值(80% 和 88%)。
温度为 0 时,无论推理强度如何,两个模型经常无法解出答案便结束游戏。启用采样后,中等推理强度使训练后模型的解题率提高 15 个百分点,使基础模型提高 46 个百分点。适配器在所有设置下都带来了 14–54 个百分点的提升,说明训练所学能够迁移到不同设置。
训练任务在 MLflow 中自身的验证曲线则呈现出不同情况:在第 90 步达到 48%,最终降至 37%,评分时的温度为 0。超参数参考文档建议评估时使用温度 0,因为贪心解码能让曲线保持确定性,便于比较不同运行结果。我们报告温度 1.0 下的结果,因为这是模型的服务设置。在中等推理强度、温度为 1.0 时,训练后模型能解出 84% 的留出单词,而基础模型为 61%。
提示:请在实际部署时使用的设置下进行评估。训练曲线显示,该适配器最终得分为 37%。在部署设置下,它能解决 84% 的问题。显示这一结果的评估任务消耗的令牌费用约为 $1.20,耗时约一小时。
步骤 8:清理
训练和评估任务完成后便会停止计费,但 AgentCore 运行时、其 IAM 角色、MLflow 应用和 S3 对象会继续保留。在项目目录中:
# 1. Agent runtime and its execution role. remove all resets the project config;
# the next deploy sees the empty state and tears down the deployed resources.
cd sample-multi-turn-rl-wordle/Wordle
agentcore remove all
agentcore deploy

# 2. MLflow app
aws sagemaker delete-mlflow-app --arn arn:aws:sagemaker:<REGION>:<ACCOUNT>:mlflow-app/<APP_ID>

# 3. Datasets, job output, and evaluation output
aws s3 rm s3://<YOUR_BUCKET>/wordle-mtrl/ --recursive
由于 agentcore remove all 会重写 agentcore/ 下的文件,如果你之后想要重新部署,请运行 git checkout -- agentcore/。删除 AgentCore-Wordle-default CloudFormation 堆栈会移除相同的资源,但会保留文件。训练任务角色和模型包不会产生费用。
深入探讨:设计奖励
我们的奖励设计经过了一次修订,而这类错误很常见。
最初的设计是在整个游戏中累加 wordle-lora-rl 项目针对每次猜测的评分。这种评分在该项目中有效,因为每次猜测都是独立的训练样本。将其累加为每局游戏的单个奖励后,出现了两个反转,只有通过阅读跟踪记录我们才发现:
- 输掉游戏却获得了正奖励。六回合的奖励累加后约为 +0.49。
- 第 1 回合解出谜题的得分低于第 3 回合解出谜题。因为额外回合会累积更多奖励,所以第 1 次猜测就猜中的得分为 +0.99,而第 3 次猜测才猜中的得分为 +1.61。
修正方法是将占主导地位的结果项与幅度较小且有界的塑形项分开:
reward = outcome + w * clip(shaping, -1, 1), w = 0.04 if solved, else 0.15结果项完全由游戏的结束方式决定:
| 结果 | 值 |
| 第 n 次猜测时解出谜题 | 1.05 + 0.5 * (6 – n) / 5,因此第 1 次猜测时为 1.55,第 6 次猜测时为 1.05 |
| 六次猜测全部用完,仍未解出 | -0.5 |
| 从未作出有效猜测 | -1.5 |
塑形项是每次猜测的评分在整局游戏中的总和:
- 因违反已知的绿色、黄色或灰色字母提示、重复猜测以及猜出词典外的单词而产生的惩罚。
- 对优质开局单词给予熵奖励。
- 对尝试新字母以及缩小剩余可能答案集合给予奖励。
总和会裁剪到 [-1, 1],并在解出谜题时乘以 0.04,在输掉游戏时乘以 0.15,因此它能区分结果相同的游戏,但不会让游戏跨越到另一个等级。使用典型的塑形值时:
| 情形 | 奖励 |
| 第 1 次猜测时解出谜题 | +1.550 |
| 第 3 次猜测时解出谜题 | +1.375 |
| 第 6 次猜测时解出谜题 | +1.069 |
| 六次猜测后仍未解出 | -0.427 |
| 从未作出有效猜测 | -1.500 |
现在,更快解出的游戏始终优于较慢解出的游戏,每场胜利都优于每场失败,而从未进行游戏是最差的结果。我们最初的修正采用单一权重 0.15,导致塑形效果达到最大值的第 3 次猜测解出谜题(+1.45)得分高于塑形效果最低的第 2 次猜测解出谜题(+1.25)。相邻猜测次数的间隔为 0.1,因此较小的解题权重 0.04 能消除分数重叠,而且最差的解题得分(+1.01)仍高于 1.0 的成功阈值。塑形仍然重要,因为 GRPO 会从一组样本中的奖励差异中学习,因此,即使两局都输了,只要线索一致性不同,也仍能教会模型一些东西。正如 SageMaker AI 文档所建议的,应从基于结果的奖励开始,谨慎添加塑形,并在真实轨迹上检查奖励。
深入探讨:你将遇到的问题及其发生顺序
以下每个问题至少耗费了一次训练运行。
- 并发情况下的 Bearer 令牌。每次调用都使用新的 botocore 会话来生成令牌,会在 32 个并发 rollout 下耗尽凭证提供程序的资源;而将令牌缓存一小时,则会在凭证轮换时导致 403 错误。解决方法是使用一个可自动刷新的会话、设置较短的缓存时间,并在收到 403 时重新签名。
- 如果一次 rollout 始终没有触达策略模型,整个任务就会失败。当一次 rollout 中的所有模型调用都因身份验证失败时,服务会以“未收到采样请求”结束任务。返回错误状态同样会导致任务失败,因此始终要返回奖励。模型虽然被采样,但始终没有做出有效猜测的游戏也没问题:得分为 -1.5;在约 105,000 次 rollout 中,100 步运行有 51 次出现这种情况。
- 工具调用会退化为纯文本。学习率过高时,模型会把工具调用写成文本,导致每次 rollout 都得到相同的最低奖励,梯度也随之消失。现在,智能体可以从原始文本中恢复猜测,并施加较小的格式惩罚。
- 训练陷入平台期。训练奖励在约第 15 步后不再上升,验证结果也在约第 30 步后停止改善,尽管温度为 0 时,验证结果低估了模型的实际表现(第 7 步)。接下来我们会尝试使用先前猜测作为游戏初始状态的课程学习,或将每个单词的 rollout 数量提高到默认值
group_size8 以上。
结论
SageMaker AI 上的 MTRL 根据整个回合的结果训练模型。这适用于智能体任务:正确的行动轨迹无法预先确定,只能对最终结果评分。我们使用了单一的回合级奖励。如果也能为中间步骤评分,MTRL 还可通过 UpdateReward API 为每个轮次接收一个奖励。在本文中,一个开放权重的 20B 模型在服务配置下的解题率达到 84%,高于此前的 61%;训练 token 成本约为 $339,AgentCore 运行时用量成本约为 $79。训练曲线报告的 37% 是训练任务对验证集评分方式造成的结果,因此应使用实际服务时的配置进行评估。
同一套流程也适用于公共模型从未接受过训练的内部流程、工具和工作流。
要开始使用,请克隆示例代码库,按照前述步骤操作,并在投入 GPU 计算资源前运行第 3 步中的冒烟测试。有关底层 API 的信息,请参阅 SageMaker AI MTRL 文档。
作者简介

Daniel Quang
Daniel 是 AWS 前沿 AI 初创企业团队的解决方案架构师,帮助全球规模最大、最具战略意义的生成式 AI 初创企业扩展其云基础设施。他拥有加州大学欧文分校计算机科学博士学位,研究方向为机器学习和生物信息学。

Hadrien Almela
Hadrien 是 AWS 初创企业团队的高级前沿 AI 客户经理,帮助顶尖 AI 初创企业建立技术集成和全球市场拓展 (GTM) 合作伙伴关系。他在初创企业领域拥有八年经验。

Vinay Bhat
Vinay 是 AWS 前沿 AI 解决方案架构部门负责人,领导一支技术团队,帮助基础模型实验室和 AI 原生初创企业在 AWS 上构建、训练和扩展模型及应用。他拥有 20 多年经验,曾在 AWS、Google Cloud 和高速增长型初创企业组建技术团队。
来源:AWS Machine Learning Blog · aws.amazon.com