AWS 介绍如何在 AgentCore 和 OpenClaw 上构建上下文感知 AI 助手
Building a context-aware AI assistant on AgentCore and OpenClaw
AWS Machine Learning Blog 介绍了在 Amazon Bedrock AgentCore runtime 和 OpenClaw 上构建上下文感知个人助手的方法。
文章把记忆命名空间、模型路由和提示词缓存串成可复用架构,便于迁移到其他个人助理场景。
现成的 AI 助手能很好地回答单个问题,但它们在另一个维度上表现不足:连续性。今天问一个无状态助手关于你花园的问题,它并不知道你三周前提到过你的高架花床排水很快、你只使用有机肥,或者你的矮牵牛在热浪中长势不佳。每次对话都从零开始,重新解释上下文的负担落在用户身上。
问题不在于回答质量,而在于助手没有关于你的记忆。本文展示如何使用 OpenClaw(一个开源智能体系统)在 AgentCore runtime 上运行,构建一个能够积累上下文的个人助手;AgentCore runtime 是 Amazon Bedrock AgentCore 的一项能力。AgentCore memory 是 Amazon Bedrock AgentCore 的一项能力,可将一次性的聊天转化为持久知识。你还将看到如何用结构化元数据标记这些记忆,以检索与当前问题相关的记录。
我们的贯穿示例是 Sprout,一个园艺助手,但该架构与领域无关。替换角色设定和技能清单,同一条流水线就可以服务于支持机器人、健身教练或内部帮助台。整个系统都在一个 AWS CloudFormation 模板中,用一条命令即可部署,并以按用量计费的模式运行,轻度个人使用每月只需几美元。在此过程中,我们会分享可应用于你在该技术栈上构建的助手的设计指南。
解决方案概述
AgentCore 是一个用于大规模构建、连接和优化智能体的平台,可配合任何框架或模型使用。下图展示了端到端请求流,从传入的 Telegram webhook 经过 AgentCore runtime,以及其支持性的 AWS 服务。

图 1:Telegram webhook 和 Amazon EventBridge 计划任务都会调用同一个 AgentCore runtime 智能体,该智能体协调 OpenClaw 网关、AgentCore memory 和 Amazon Bedrock
两个入口点汇聚到一个智能体。Telegram 消息通过 Amazon API Gateway 和一个 webhook AWS Lambda 函数到达,而诸如早晨浇水提醒之类的计划任务则通过 Amazon EventBridge Scheduler 和一个 cronjob Lambda 函数到达。两者都会调用 AgentCore runtime 上的 InvokeAgentRuntime API,其中一个轻量级的 server.py 进程会协调 OpenClaw 网关、AgentCore memory 和 Amazon Bedrock Converse API。Amazon Simple Storage Service (Amazon S3) 提供工作区存储,AWS Key Management Service (AWS KMS) 处理加密,AWS Secrets Manager 保存机器人令牌,Amazon CloudWatch 捕获日志和指标。
先决条件
要使用 Launch Stack 按钮或 scripts/deploy.sh(在“自己动手构建”部分介绍)部署你自己的版本,你需要:
- Amazon Bedrock AgentCore 访问权限,包括 AgentCore runtime 和 AgentCore memory。
- 已获准访问你计划路由到的模型:用于文本的 Claude Haiku 4.5 和用于视觉的 Claude Sonnet 4.5(或你账户中可用的等效模型)。
- 支持
linux/arm64build 的 Docker,以及已配置的 AWS Command Line Interface (AWS CLI)。只有在你计划构建并推送自己的镜像时才需要这些。 - 一个 Telegram 机器人令牌(来自 BotFather),作为助手的前门。
- 对智能体编排概念和 CloudFormation 有基本了解。
架构:AgentCore runtime 上的无服务器智能体
每个组件都位于一个 CloudFormation 模板中,启动时不需要任何构建工具。以下部分将逐一介绍关键的承重决策。
AgentCore 运行时:只为活跃计算付费
该代理运行在 AgentCore runtime 上的容器中,后者采用基于用量的定价。你需要为代理实际消耗的计算资源付费,而不是为按墙钟时间计算的正常运行时间付费;当等待模型响应等 I/O 时,你也无需付费。对于一个以短时突发方式使用的个人助理而言,这意味着基线费用约为 $1–2/月,而始终在线的 Amazon Elastic Compute Cloud (Amazon EC2) 实例约为 $35/月。这些数字是截至 2026 年 7 月针对轻度个人使用的估算值。请参阅 AgentCore 定价 了解当前费率。
该运行时强制执行一个最小容器契约:监听端口 8080,并公开 GET /ping 用于健康检查,公开 POST /invocations 作为代理入口点。我们的容器是 linux/arm64,基于官方 OpenClaw 镜像并添加 Python 层,通过多阶段构建而成。
OpenClaw 作为代理底座
OpenClaw 提供代理循环、工具使用和技能系统。它运行一个包装器(server.py),将其适配到 AgentCore HTTP 协议契约:
- 容器启动时,
server.py会将openclaw gateway run作为子进程启动,并对其进行健康检查。 GET /ping会快速返回健康状态,因此 AgentCore 就绪探针会通过。POST /invocations执行真正的工作:解析载荷、检索记忆、组装上下文、将本轮交互转发到网关,并持久化结果。需要特别指出的是:AgentCore 可以解冻一个其子进程已经退出的冻结容器。因此,调用路径不会假设网关仍在运行,而是会调用一个ensure_openclaw_ready()辅助函数,在转发本轮交互之前重新检查健康状态(并在需要时重启网关)。
这种包装器模式可推广到其他用例。任何作为本地进程运行的代理框架都可以用同样的方式适配到 AgentCore runtime,而无需修改框架本身。
两个模型,按任务路由
文本聊天和图像理解在成本与质量上的取舍不同,因此该助理会将它们路由到 Bedrock 上的不同 Claude 模型:
- Claude Haiku 4.5 用于文本:对于日常使用中占主导的高频对话轮次而言,速度快且成本低。
- Claude Sonnet 4.5 用于视觉:针对通过照片诊断植物这种不太频繁但更困难的任务,提供更强的多模态推理能力。
文本轮次会流经 OpenClaw 网关,由其提供技能和会话状态。图像轮次则由 server.py 直接调用 Bedrock 的大型语言模型(LLM),并将图像字节作为多模态内容块传入。我们有意让图像绕过网关:容器内的 OpenClaw 构建会在 image_url 内容部分到达 Bedrock 之前将其丢弃,因此从 server.py 直接调用 Converse API 可确保模型看到实际像素。两条路径共享同一个系统提示词(人格设定加记忆),因此体验保持一致。
模型 ID 是环境变量(MODEL_ID、VISION_MODEL_ID),因此你可以在每次部署时更换模型,而无需重建镜像。
将技能作为可复用的能力单元
能力在 community-skills.json 清单中声明为技能。一个部署时脚本会将它们实体化到容器中,并在镜像构建之前把它们注册到 OpenClaw 配置中。本文发布时,Sprout 随附天气、提醒和植物笔记技能。替换清单,同一条流水线就可以服务于不同领域。这正是让整个方案成为一种可复用模式、而不只是一个机器人的原因。
Telegram 作为无服务器前门
Telegram 是个人助手的实用渠道,因为它基于 webhook,并且让一切保持无服务器。它不需要客户端开发,可在用户已有的每台设备上运行,并通过直观的 bot API 支持文本、图片和富格式。BotFather 会发放一个 bot token,并将其存储在 Secrets Manager 中。部署会注册一个 webhook,将 Telegram 指向 API 网关端点。当用户发送消息时,Telegram 会将其传递给 webhook Lambda 函数,以验证 payload 并调用 InvokeAgentRuntime。回复会通过 telegram bot API 返回。
有一个格式化方面的经验值得注意:Telegram 的旧版 markdown 模型对未转义字符非常不宽容,模型回复中一个多余的下划线就可能导致整条消息发送失败。将回复渲染为 HTML 更可靠,因此助手会在发送前将模型输出转换为 Telegram 安全的 HTML。
记忆:将一次性聊天转化为持久知识
到目前为止描述的架构是一个功能强大、廉价的无服务器 agent,但就其本身而言,它仍然会在对话之间忘记你。记忆改变了这一点。设想一下,你几周前提到过自己采用有机方式种植,今天助手推荐了一种处理方法,并自行补充说,它选择有机方案是因为你不使用合成肥料。无状态模型做不到这一点。
心智模型:短期事件,长期提取
AgentCore memory 有两层。短期记忆通过 CreateEvent 将每一轮对话存储为事件,并以 actorId(Telegram chat ID)和 sessionId 作为键。这是原始记录。长期记忆由托管提取策略异步生成,形成持久的结构化记录。我们配置了三种策略:
USER_PREFERENCE:园丁明确表达的选择(“我只使用有机肥料”)。SEMANTIC:推断出的事实(“在 Corten steel 高架花床中种植 Mexican petunias”)。SUMMARIZATION:情节式会话摘要(“讨论了热浪期间下部叶片发黄的问题”)。
命名空间:每位园丁一个花园
Sprout 会将记录归档到按用户划分的命名空间中,因此两个聊天永远不会混在一起:
sprout/{chat_id}/long_term:偏好和语义事实。sprout/{chat_id}/episodic/{session_id}:会话摘要。
chat ID 是唯一的可变片段,这让隔离很容易推理和测试:每位唯一的园丁都映射到且仅映射到一个命名空间,且任意两位园丁都不会冲突。
检索、组装和注入流水线
在每一轮中,agent 都会检索相关的长期记录,对它们进行排序,并将它们注入到系统提示中。以下是在每一条消息中、在 server.py 内部发生的事情:
- 检索。 对
sprout/{chat_id}/long_term调用RetrieveMemoryRecords,使用用户消息作为搜索查询,结果上限为 50 条,时间预算为 3 秒。如果检索超时或出错,我们会优雅降级,在没有记忆的情况下回答,而不是失败。
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
代码片段 1:检索当前轮次的长期记录(代表性示例。完整源代码请参见 repo)。
Assemble 函数会添加额外的自定义逻辑。我们希望显式偏好排在推断事实之前,每一类内部的顺序保持稳定,并在注入前限制结果数量:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
代码片段 2:组装步骤将显式偏好排在推断事实之前。
元数据:在命名空间内对记忆进行子分组
命名空间回答一条记忆记录是谁的,但元数据回答它是关于什么的。在 sprout/{chat_id}/long_term 内,对“my petunias are wilting”进行语义搜索,会返回所有含义相近的内容。对于园丁来说,这意味着 3 月的一项肥料偏好,以及一条无花果树修剪笔记,会与真正相关的记录一起被排序。而结构化元数据有助于我们在记忆到达提示词之前缩小其范围。
这里有一条规则会影响每个决策。元数据键只有在你将其声明为索引键时,才能在服务器端进行筛选。你可以在 Amazon Bedrock AgentCore Memory 中使用元数据进行结构化记忆筛选 中阅读更多内容。在这个案例中,sprout 使用了三个索引键:
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
每个条目都会命名一个键;该键必须与某个索引键匹配,才能被筛选,并将 extractionType 设置为从事件传入的 STRICTLY_CONSISTENT,或从对话中提取的 LLM_INFERRED。对于推断出的键,提取配置可以将值限制在固定列表中。Sprout 正是这样做的,因此两条写入路径都会创建相同的词汇表,而无论记录由哪个部分创建,筛选条件的含义都是一致的。
持久化该轮对话并闭合循环
模型响应后,server.py 会使用用户轮次和助手轮次一起调用 CreateEvent。这个新事件会馈入提取策略,从而丰富长期存储,以备下次使用。
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
代码片段 3:持久化该轮对话,使提取策略能够异步丰富长期记忆。
提取是异步的,因此本次会话中提到的事实通常会在之后的会话中变得可检索。请为这种延迟进行设计:短期会话事件覆盖当前对话,而长期记录覆盖此前的一切。
整合起来:个性化浇水计划
这就是完整流水线端到端发挥作用的地方。经过几次对话,你可以用自然语言一次记录一种植物,逐步编目整个花园。每次提及都会成为一个事件。提取策略会把关于植物、位置以及日照情况的信息提取到 sprout/{chat_id}/long_term 中。今天早上,用户问了一个问题:“你还记得我花园里的其他植物吗?”检索会拉回这些记录,组装会对它们排序,然后它们会进入系统提示词。助手给出的回答包含用户的位置、日照情况、花坛构造、土壤行为和植物清单,而这些信息都没有出现在消息本身中。
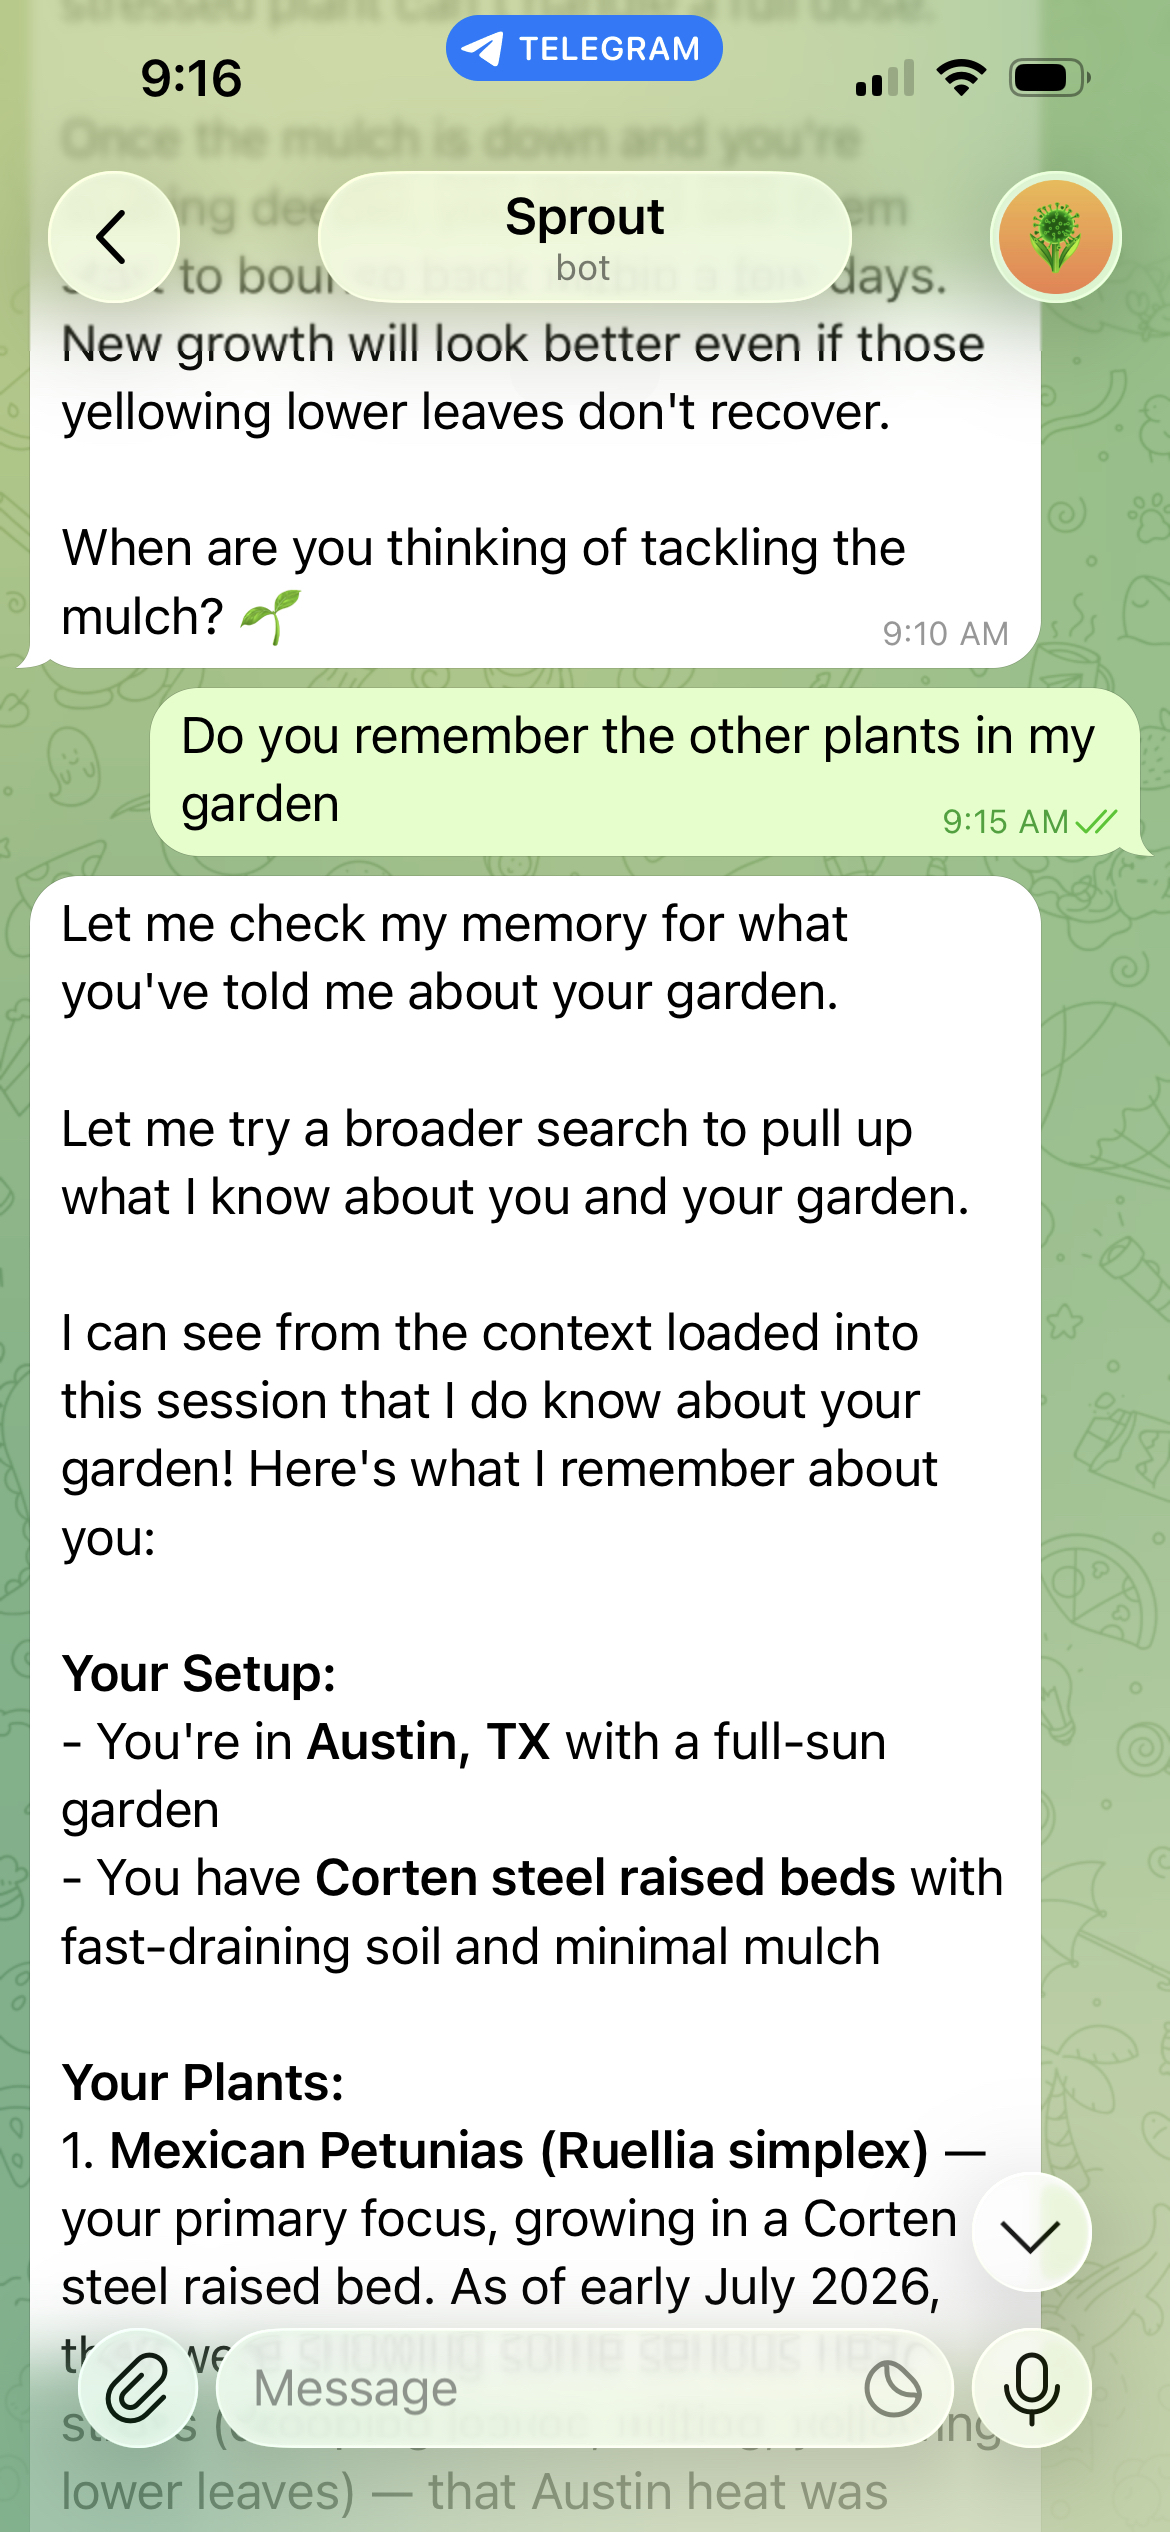
图 2:Sprout 通过回忆已存储的植物清单和生长条件,回答关于花园的问题
通过 Amazon EventBridge → Cron 路径上的调度器技能,Sprout 还可以把该计划转化为主动提醒(“跳过香草,土壤仍因昨天的浇水而潮湿”),并在即将下雨或出现热浪时,结合天气技能对提醒进行调整。
记忆和视觉也会相互增强。当用户发送一张枯萎植物的照片时,图像会发送给 Claude Sonnet 4.5,同时系统提示词仍会携带记忆层所知道的一切。助手会把照片与用户已保存清单中的 Mexican petunias 匹配起来,并在上下文中诊断萎蔫胁迫,而不是冷启动分析一张匿名植物照片。
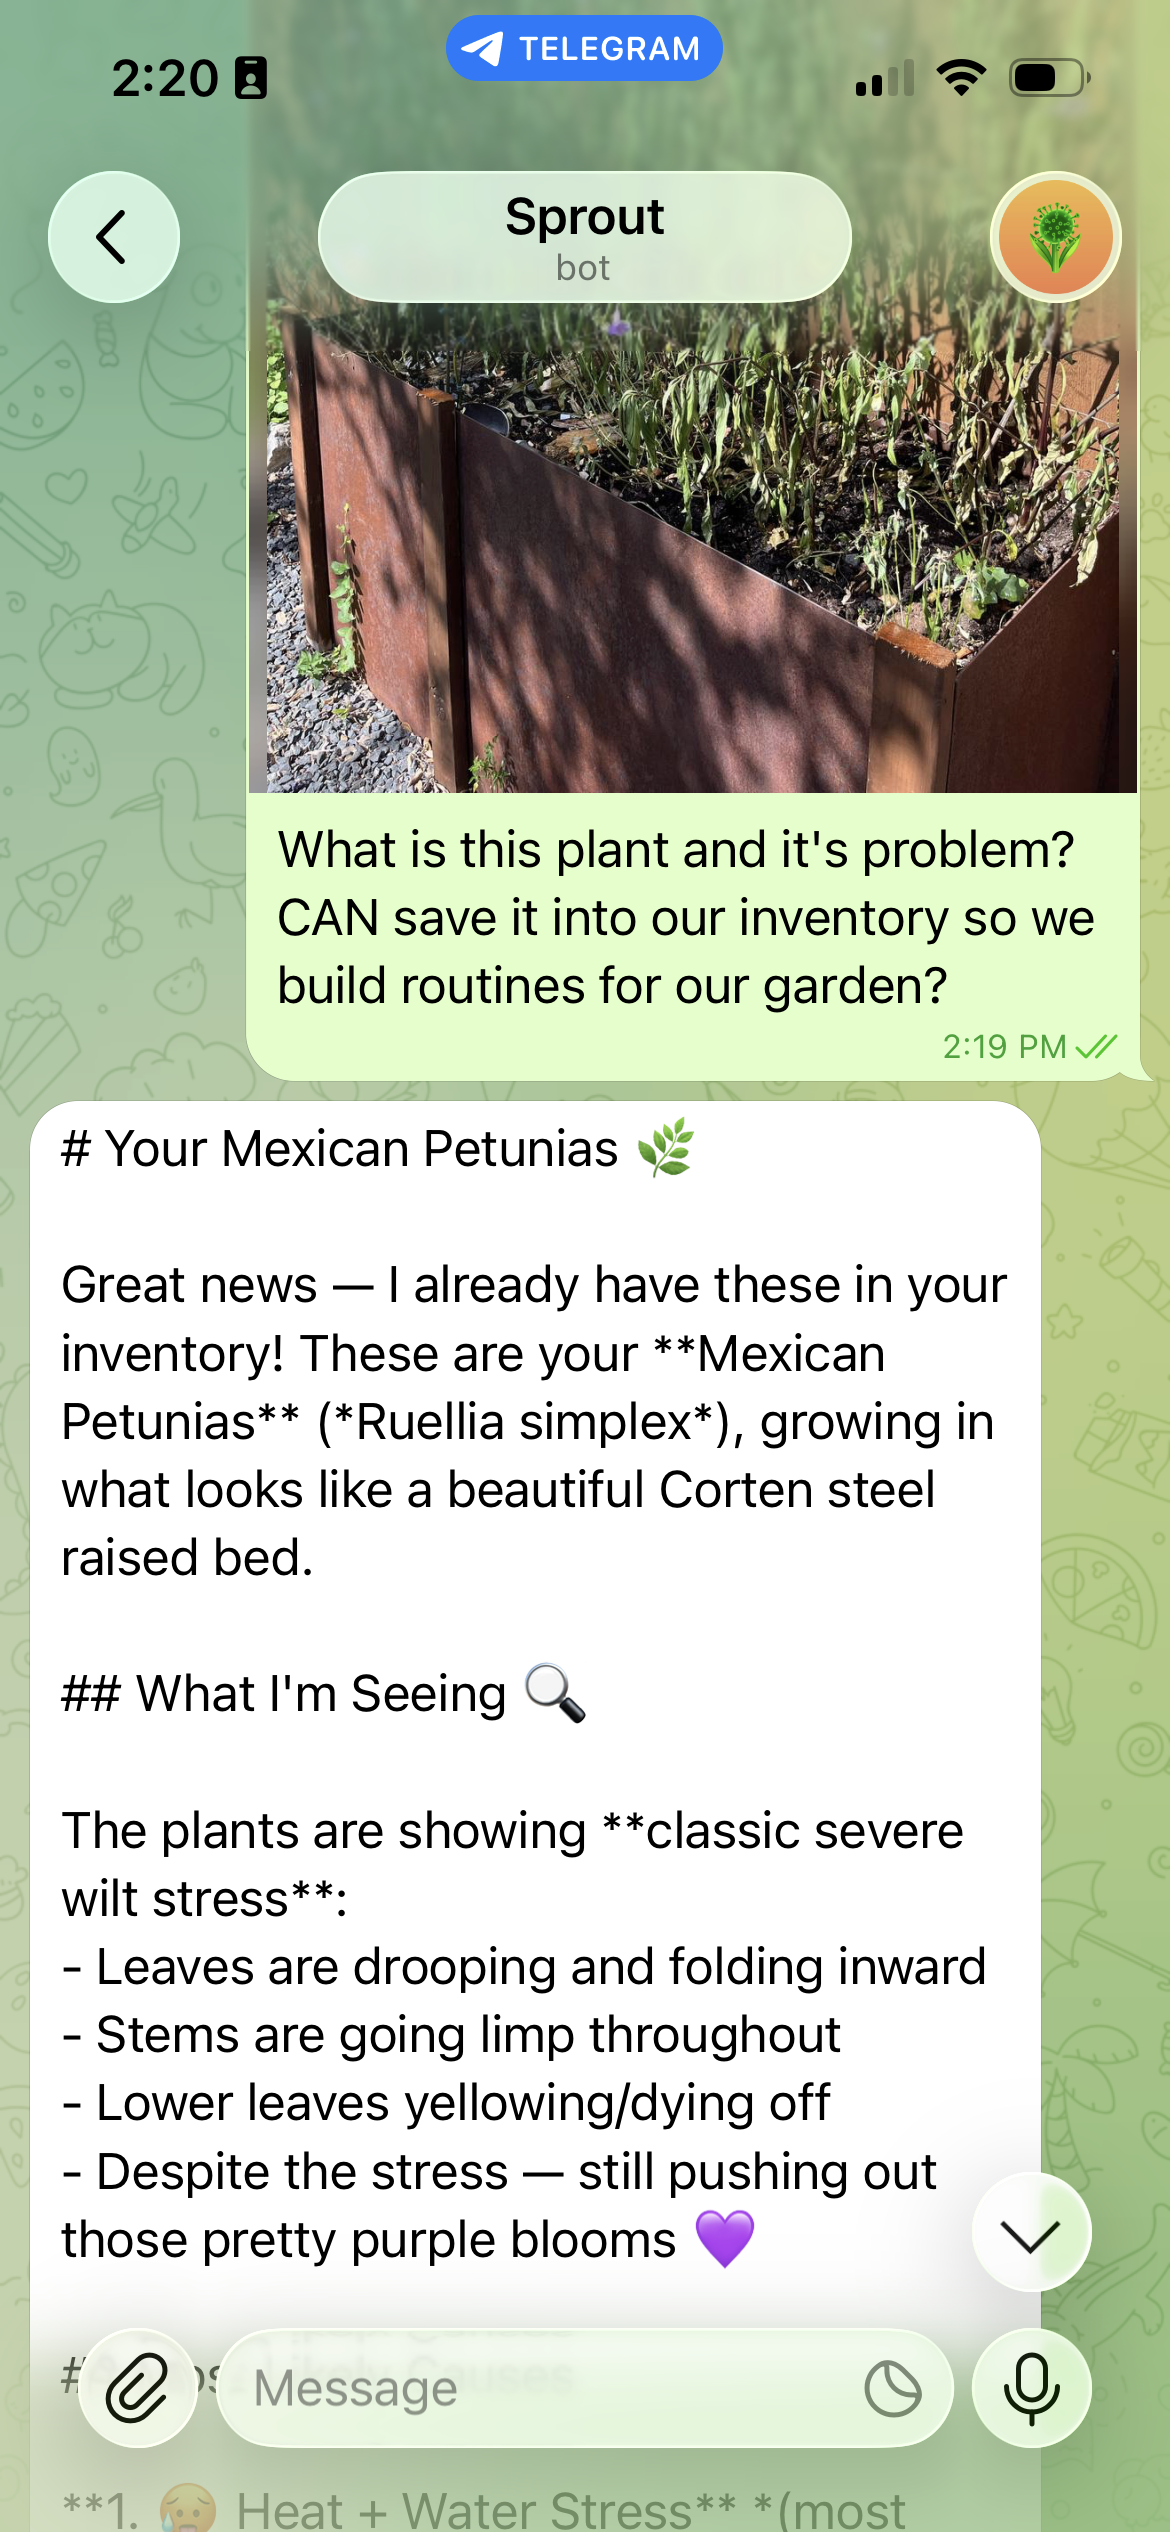
图 3:视觉与记忆协同工作。照片发送给视觉模型,同时系统提示词携带用户已存储的花园上下文
视觉模型并非万无一失。在之前一次没有库存上下文的交流中,同一株植物被很自信地识别为牵牛花——一种有着相似喇叭形紫色花朵的物种。用用户自己存储的库存来为视觉模型提供依据,才把一个听起来合理的猜测变成了正确、个性化的诊断;这也很好地说明了为什么记忆提升的是准确性,而不只是语气。
通过提示缓存保持较低的推理成本
在每一轮中注入记忆会让系统提示变得很大,而天真的实现会在每次请求时都为这些 token 付费。Amazon Bedrock 上的提示缓存解决了这一点。该助手会组织其提示,使稳定的前缀——角色设定和组装好的记忆块——放在最前面,而易变的用户消息放在最后。Bedrock 会跨请求缓存已处理的前缀,因此一次对话中的重复轮次会跳过对未变化部分的重新计算。对于受支持的模型,提示缓存最多可将成本降低 90 percent,并将延迟降低 85 percent。
排序规则比任何单个设置都更重要:把稳定内容放在前面,把易变内容放在最后,并保持记忆块内部排序具有确定性(前面的组装函数有助于实现这一点),这样请求之间的前缀才会真正匹配。
基于 AgentCore 和 OpenClaw 构建的设计指南
Sprout 是一个助手,但其背后的决策具有普适性。如果你正在这个技术栈上构建自己的助手,以下指南是我们会带到任何领域中的做法。
- 封装,不要分叉。 用一个轻量 HTTP 包装器让你的 agent 框架适配 AgentCore 容器契约,而不是修改框架本身。这个契约很小:端口 8080,配合
/ping和/invocations;包装器能让你继续跟随框架的升级路径。 - 在存储任何内容之前先设计命名空间。 记忆命名空间是你的隔离边界。让用户 ID 成为唯一的可变段,并从你已经信任的渠道原生 ID 中选择它,例如 chat ID。多租户设计最终都会遇到审计和删除请求。清晰的命名空间方案会让二者都变得很简单。
- 把记忆视为增强,而绝不是依赖。 每个记忆操作都应该允许优雅失败。检索失败时应生成没有记忆的回答,而不是阻塞回复。相比一次失败的交互,用户更容易原谅一次健忘的交互。
- 按任务路由模型。 对高频文本使用快速且具成本效益的模型,并把更强的多模态模型留给真正需要它的轮次。将模型 ID 放在环境变量中,这样路由变更就是配置问题,而不是代码问题。
- 为缓存安排提示顺序。 稳定的角色设定和记忆在前,易变的用户输入在后,全程采用确定性排序。大多数推理节省都来自这一结构性习惯。
- 为提取延迟做好规划。 长期记忆是异步提取的,所以不要承诺在同一会话中就能回忆起新事实。让短期会话事件覆盖当前对话,让长期记录覆盖此前的对话。
- 从第一天起就给它设预算。 基于用量计费的 agent 一开始并不贵,直到重试循环或话多的用户让情况发生变化。AWS Budgets 在月度上限的 80 percent 和 100 percent 处发出告警不需要成本,并能及早发现意外。
- 保持技能小而单一用途。 一个技能应只做一件用户会用一句话说出的事,例如查看天气或设置提醒。小技能可以独立测试、独立替换,也便于模型正确选择。一个包办一切的技能会迫使模型猜测你想要的是它的哪种行为。
种植你自己的
两种种下它的方式,同一个花园:
- 单步 Launch Stack: CloudFormation 模板指向一个公开的 Amazon Elastic Container Registry (Amazon ECR) 镜像,因此它只需部署一个 Telegram 机器人令牌。
- 构建你自己的:scripts/
deploy.sh脚本会验证模板,构建你的 ARM64 镜像并推送到你的私有 Amazon ECR 存储库,部署堆栈,并注册 Telegram webhook,从而实现完全可自定义的构建。
截至 2026 年 7 月,轻量级个人使用的运行成本约为每月 $5–9(大致为 $2 基础设施、$1–3 Haiku 文本、$2 Sonnet 视觉),并内置 AWS Budget,可在达到你设置上限的 80 percent 和 100 percent 时发出提醒。
完整源代码可在 sample-agentcore-memory-openclaw GitHub 存储库 中获取。
清理
实验完成后,请拆除所有资源以避免持续产生费用。由于整个系统是一个 CloudFormation 堆栈,清理基本上只需一次删除:
- 删除 CloudFormation 堆栈。这会移除 AgentCore 运行时代理、API Gateway、Lambda 函数、Amazon EventBridge 计划任务,以及相关的 AWS Identity and Access Management (IAM) 角色。
- 删除 AgentCore 内存存储(及其命名空间),以确保不保留任何用户记录。
- 删除你推送到私有 ECR 存储库的所有镜像;如果不再需要该存储库,也将其删除。
- 如果你在堆栈之外创建了 AWS Budget 提醒,请将其移除。
- 撤销 Telegram 的 webhook(或通过 BotFather 删除该机器人),如果不再需要 Bedrock 模型访问权限,也将其撤销。
结论
此解决方案的可复用核心是在 Amazon Bedrock AgentCore 上运行的无服务器代理,配有技能系统和托管内存。AgentCore 内存省去了构建自定义向量存储和提取管道的需要,同时让你完全控制代理记住什么和忘记什么;基于用量的计算加上提示缓存,可将真正个性化助手的成本维持在每月几美元;OpenClaw 技能清单则让整个模式可移植到不同领域。个性化还会产生复合效应:用户互动越多,助手就越有用。
要进一步探索,可以从单一领域开始,例如浇水提醒,并逐步扩大内存范围;探索情节记忆,让代理能够引用过去的具体对话(“上次我们讨论无花果树时,你决定暂缓施肥”);或者 fork 这个 存储库,替换成你自己的角色设定和技能,培养出你需要的任何助手。
要了解更多信息,请参阅 AgentCore 文档。以下相关文章更深入地介绍了这些构建模块:
- Amazon Bedrock AgentCore 内存:构建具备上下文感知能力的代理
- 构建更智能的 AI 代理:AgentCore 长期记忆深度解析
- 在 Amazon Bedrock 上有效使用提示缓存
- 在 Amazon Bedrock AgentCore runtime 上安全地启动并扩展你的代理和工具
关于作者

Thiago Verney
Thiago 是 Amazon One MHS 团队的前端工程师,专注于使用 React、TypeScript 和现代联邦微前端架构构建由 AI 驱动的界面。他为 FC 的运营领导者构建以用户为中心的界面,此前曾在 AWS 的 Amazon Q Developer(现为 Kiro)团队工作。他热衷于创新,致力于打造切实可行的解决方案,解决真实的用户问题。闲暇时,他喜欢在位于得克萨斯州奥斯汀的家中园艺、旅行,并和妻子一起培养各种兴趣爱好。

Sathya Balakrishnan
Sathya 是 Amazon Web Services(AWS)专业服务团队的首席云架构师,专注于数据和机器学习(ML)解决方案。他为美国联邦金融客户提供服务。他热衷于构建切实可行的解决方案,解决客户的业务问题。闲暇时,他喜欢看电影,并和家人一起徒步旅行。

Akarsha Sehwag
Akarsha 是 Amazon Bedrock AgentCore GTM 团队的高级生成式 AI 数据科学家。凭借超过 7 年的 AI/ML 专业经验,她在生成式 AI、深度学习和计算机视觉领域,面向不同客户群体构建了可投入生产的企业级解决方案。工作之余,她喜欢徒步、骑自行车和打羽毛球。
来源:AWS Machine Learning Blog · aws.amazon.com